
Diffusers documentation
Marigold Computer Vision
Marigold Computer Vision
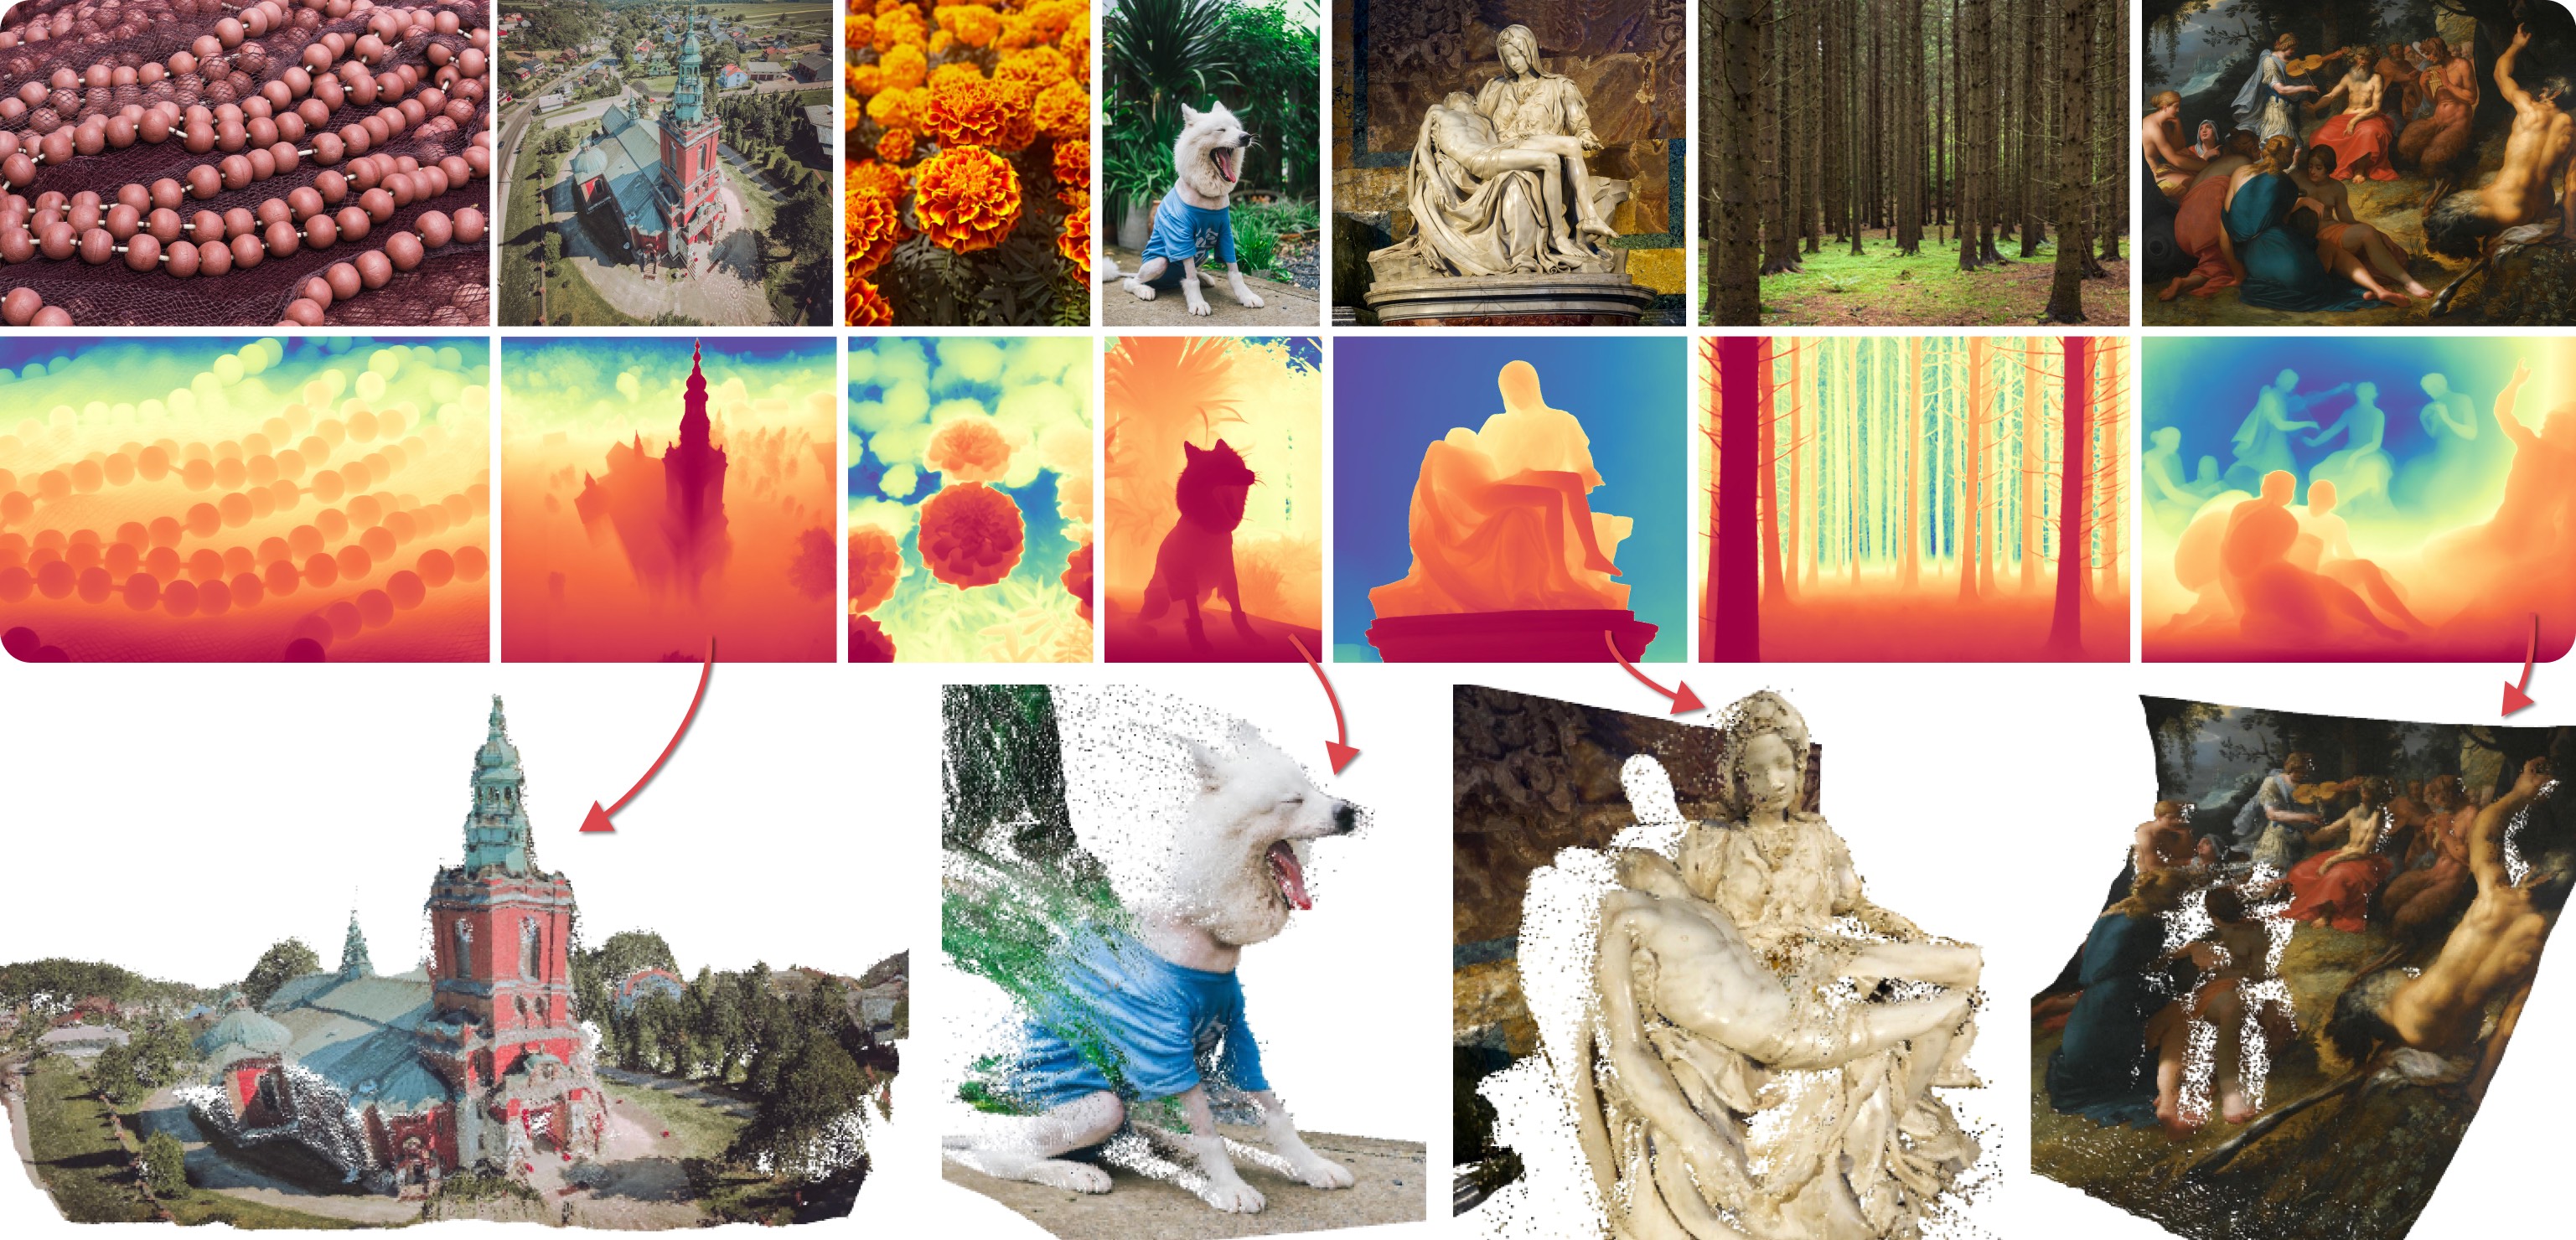
Marigold diusulkan dalam Repurposing Diffusion-Based Image Generators for Monocular Depth Estimation, sebuah makalah Oral CVPR 2024 oleh Bingxin Ke, Anton Obukhov, Shengyu Huang, Nando Metzger, Rodrigo Caye Daudt, dan Konrad Schindler. Ide intinya adalah menggunakan kembali prior generatif dari Text-to-Image Latent Diffusion Models (LDMs) untuk tugas computer vision tradisional. Pendekatan ini dieksplorasi dengan fine-tuning Stable Diffusion untuk Monocular Depth Estimation, seperti yang ditunjukkan dalam teaser di atas.
Marigold kemudian diperluas dalam makalah lanjutan, Marigold: Affordable Adaptation of Diffusion-Based Image Generators for Image Analysis, yang ditulis oleh Bingxin Ke, Kevin Qu, Tianfu Wang, Nando Metzger, Shengyu Huang, Bo Li, Anton Obukhov, dan Konrad Schindler. Karya ini memperluas Marigold untuk mendukung modalitas baru seperti Surface Normals dan Intrinsic Image Decomposition (IID), memperkenalkan protokol pelatihan untuk Latent Consistency Models (LCM), dan mendemonstrasikan kemampuan pemrosesan High-Resolution (HR).
Model Marigold awal (
v1-0dan sebelumnya) dioptimalkan untuk hasil terbaik dengan minimal 10 langkah inferensi. Model LCM kemudian dikembangkan untuk memungkinkan inferensi berkualitas tinggi hanya dalam 1 hingga 4 langkah. Model Marigoldv1-1dan setelahnya menggunakan penjadwal DDIM untuk mencapai hasil optimal dalam hanya 1 hingga 4 langkah.
Pipeline yang Tersedia
Setiap pipeline dirancang untuk tugas computer vision tertentu, memproses gambar RGB sebagai input dan menghasilkan prediksi yang sesuai. Saat ini, tugas computer vision berikut telah diimplementasikan:
| Pipeline | Checkpoint Model yang Direkomendasikan | Spaces (Aplikasi Interaktif) | Modalitas yang Diprediksi |
|---|---|---|---|
| MarigoldDepthPipeline | prs-eth/marigold-depth-v1-1 | Estimasi Kedalaman | Kedalaman, Disparitas |
| MarigoldNormalsPipeline | prs-eth/marigold-normals-v1-1 | Estimasi Normal Permukaan | Normal permukaan |
| MarigoldIntrinsicsPipeline | prs-eth/marigold-iid-appearance-v1-1, prs-eth/marigold-iid-lighting-v1-1 | Dekomposisi Gambar Intrinsik | Albedo, Bahan, Pencahayaan |
Checkpoint yang Tersedia
Semua checkpoint asli tersedia di bawah organisasi PRS-ETH di Hugging Face. Mereka dirancang untuk digunakan dengan pipeline diffusers dan codebase asli, yang juga dapat digunakan untuk melatih checkpoint model baru. Berikut adalah ringkasan checkpoint yang direkomendasikan, yang semuanya menghasilkan andal dengan 1 hingga 4 langkah.
| Checkpoint | Modalitas | Komentar |
|---|---|---|
| prs-eth/marigold-depth-v1-1 | Kedalaman | Prediksi kedalaman yang invarian terhadap afinitas memberikan setiap piksel nilai antara 0 (bidang dekat) dan 1 (bidang jauh), dengan kedua bidang tersebut ditentukan oleh model selama inferensi. |
| prs-eth/marigold-normals-v0-1 | Normal | Prediksi normal permukaan adalah vektor 3D dengan panjang satuan dalam ruang kamera layar, dengan nilai dalam rentang dari -1 hingga 1. |
| prs-eth/marigold-iid-appearance-v1-1 | Intrinsik | Dekomposisi InteriorVerse terdiri dari Albedo dan dua properti material BRDF: Roughness dan Metallicity. |
| prs-eth/marigold-iid-lighting-v1-1 | Intrinsik | Dekomposisi HyperSim dari sebuah gambar terdiri dari Albedo $A$, Diffuse shading $S$, dan Non-diffuse residual $R$: $I = A*S+R$. |
Pastikan untuk melihat panduan Schedulers untuk mempelajari cara mengeksplorasi tradeoff antara kecepatan dan kualitas scheduler, serta lihat bagian reuse components across pipelines untuk mempelajari cara memuat komponen yang sama ke beberapa pipeline secara efisien. Selain itu, untuk mengetahui lebih lanjut tentang mengurangi penggunaan memori dari pipeline ini, lihat bagian [“Reduce memory usage”] di sini.
Pipeline Marigold dirancang dan diuji dengan scheduler yang tertanam dalam checkpoint model. Jumlah langkah inferensi optimal bervariasi tergantung pada scheduler, dan tidak ada nilai universal yang paling baik untuk semua kasus. Untuk mengakomodasi hal ini, parameter
num_inference_stepspada metode__call__pipeline secara default diatur keNone(lihat referensi API). Kecuali diatur secara eksplisit, nilai ini diwarisi dari fielddefault_denoising_stepsdalam file konfigurasi checkpoint (model_index.json). Hal ini memastikan prediksi berkualitas tinggi saat memanggil pipeline hanya dengan argumenimage.
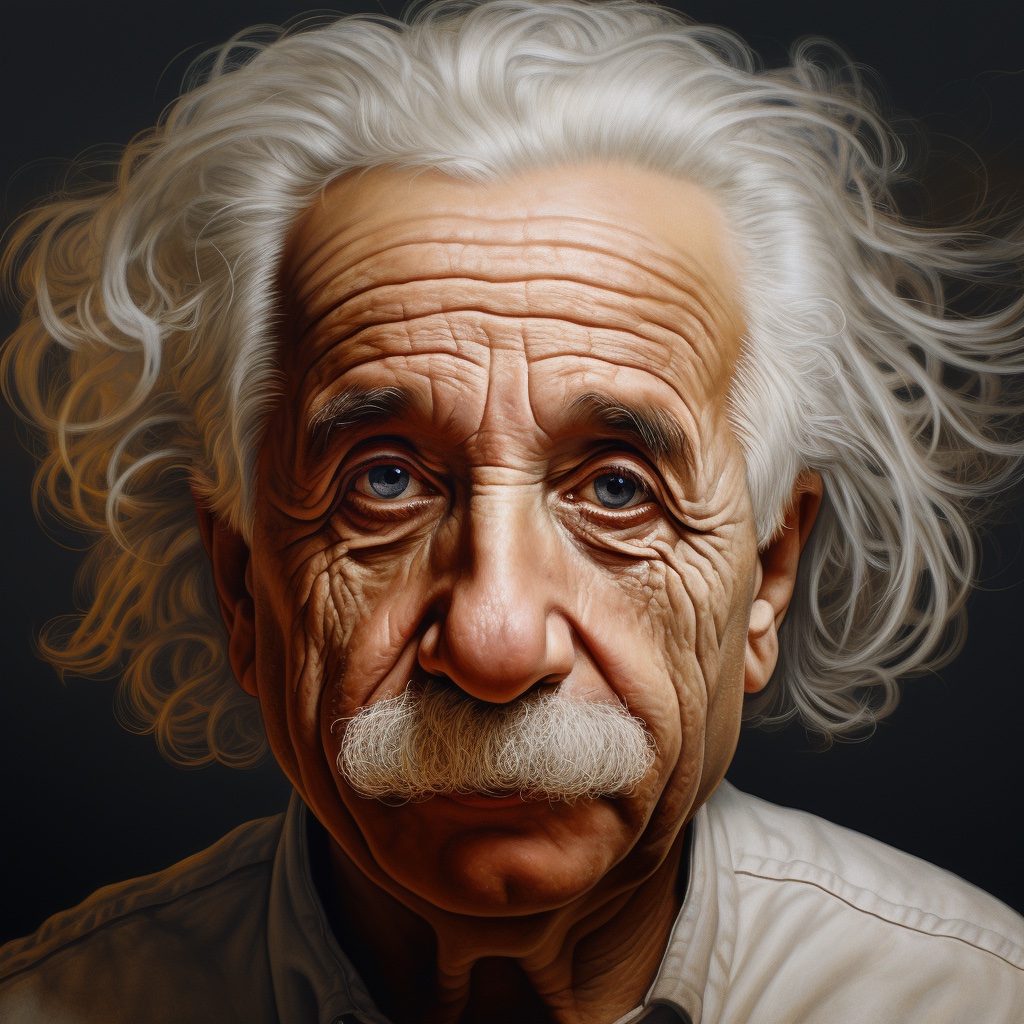
Contoh di bawah ini sebagian besar diberikan untuk prediksi kedalaman, tetapi dapat diterapkan secara universal pada modalitas lain yang didukung. Kami menampilkan prediksi menggunakan gambar input yang sama dari Albert Einstein yang dihasilkan oleh Midjourney. Hal ini memudahkan perbandingan visualisasi prediksi di berbagai modalitas dan checkpoint.
Prediksi Kedalaman
Untuk mendapatkan prediksi kedalaman, muat checkpoint prs-eth/marigold-depth-v1-1 ke dalam MarigoldDepthPipeline,
jalankan gambar melalui pipeline, dan simpan prediksinya:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(image)

vis = pipe.image_processor.visualize_depth(depth.prediction)
vis[0].save("einstein_depth.png")

depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
depth_16bit[0].save("einstein_depth_16bit.png")
Fungsi visualize_depth() menerapkan salah satu colormap matplotlib (secara default Spectral) untuk memetakan nilai piksel yang diprediksi dari rentang kedalaman satu kanal [0, 1] menjadi gambar RGB.
Dengan colormap Spectral, piksel dengan kedalaman dekat dicat merah, dan piksel jauh dicat biru.
File PNG 16-bit menyimpan nilai satu kanal yang dipetakan secara linear dari rentang [0, 1] ke [0, 65535].
Berikut adalah prediksi mentah dan prediksi yang divisualisasikan. Area yang lebih gelap dan lebih dekat (kumis) lebih mudah dibedakan dalam
visualisasi.


Estimasi Normal Permukaan
Muat checkpoint prs-eth/marigold-normals-v1-1 ke dalam MarigoldNormalsPipeline, jalankan gambar melalui pipeline, dan simpan prediksi:
import diffusers
import torch

pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
    "prs-eth/marigold-normals-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

normals = pipe(image)

vis = pipe.image_processor.visualize_normals(normals.prediction)
vis[0].save("einstein_normals.png")
visualize_normals() memetakan prediksi tiga dimensi dengan nilai piksel dalam rentang [-1, 1] menjadi gambar RGB.
Fungsi visualisasi ini mendukung pembalikan sumbu normal permukaan agar visualisasi kompatibel dengan pilihan lain dari kerangka acuan.
Secara konseptual, setiap piksel diwarnai sesuai dengan vektor normal permukaan dalam kerangka acuan, di mana sumbu X
menunjuk ke kanan, sumbu Y menunjuk ke atas, dan sumbu Z menunjuk ke arah pengamat.
Berikut adalah prediksi yang divisualisasikan:

Pada contoh ini, ujung hidung hampir pasti memiliki titik pada permukaan, di mana vektor normal permukaan mengarah lurus ke pengamat, yang berarti koordinatnya adalah [0, 0, 1].
Vektor ini dipetakan ke RGB [128, 128, 255], yang sesuai dengan warna ungu-biru.
Demikian pula, normal permukaan pada pipi di bagian kanan gambar memiliki komponen X yang besar, yang meningkatkan nuansa merah.
Titik-titik di bahu yang mengarah ke atas dengan Y yang besar mempromosikan warna hijau.
Dekomposisi Gambar Intrinsik
Marigold menyediakan dua model untuk Intrinsic Image Decomposition (IID): “Appearance” dan “Lighting”. Setiap model menghasilkan peta Albedo, yang diturunkan dari anotasi InteriorVerse dan Hypersim, masing-masing.
- Model “Appearance” juga memperkirakan properti Material: Roughness dan Metallicity.
- Model “Lighting” menghasilkan Diffuse Shading dan Non-diffuse Residual.
Berikut adalah contoh kode yang menyimpan prediksi yang dibuat oleh model “Appearance”:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["roughness"].save("einstein_roughness.png")
vis[0]["metallicity"].save("einstein_metallicity.png")
Contoh lain yang menunjukkan prediksi yang dibuat oleh model “Lighting”:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["shading"].save("einstein_shading.png")
vis[0]["residual"].save("einstein_residual.png")
Kedua model berbagi pipeline yang sama sambil mendukung jenis dekomposisi yang berbeda.
Parameterisasi dekomposisi yang tepat (misalnya, ruang sRGB vs. linear) disimpan dalam kamus pipe.target_properties, yang diteruskan ke fungsi visualize_intrinsics().
Berikut adalah beberapa contoh yang menampilkan hasil dekomposisi prediksi. Semua modalitas dapat diperiksa di Space Intrinsic Image Decomposition.


Mempercepat inferensi
Snippet quick start di atas sudah dioptimalkan untuk kualitas dan kecepatan, memuat checkpoint, memanfaatkan varian fp16 dari bobot dan komputasi, serta melakukan jumlah langkah denoising difusi default (4).
Langkah pertama untuk mempercepat inferensi, dengan mengorbankan kualitas prediksi, adalah mengurangi langkah denoising difusi ke minimum:
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=1)
Dengan perubahan ini, panggilan pipe selesai dalam 280ms pada GPU RTX 3090.
Secara internal, gambar input pertama-tama dikodekan menggunakan encoder VAE Stable Diffusion, diikuti oleh satu langkah denoising
yang dilakukan oleh U-Net.
Terakhir, latent prediksi didekodekan dengan decoder VAE ke ruang piksel.
Dalam setup ini, dua dari tiga panggilan modul didedikasikan untuk konversi antara ruang piksel dan ruang latent dari LDM.
Karena ruang latent Marigold kompatibel dengan Stable Diffusion 2.0, inferensi dapat dipercepat lebih dari 3x,
mengurangi waktu panggilan menjadi 85ms pada RTX 3090, dengan menggunakan pengganti VAE SD yang ringan.
Perlu dicatat bahwa penggunaan VAE ringan dapat sedikit mengurangi kualitas visual dari prediksi.
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
+     "madebyollin/taesd", dtype=torch.float16
+ ).cuda()

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Sampai saat ini, kita telah mengoptimalkan jumlah langkah difusi dan komponen model. Operasi self-attention menyumbang porsi signifikan dari komputasi. Mempercepatnya dapat dicapai dengan menggunakan pemroses perhatian yang lebih efisien:
  import diffusers
  import torch
+ from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae.set_attn_processor(AttnProcessor2_0())
+ pipe.unet.set_attn_processor(AttnProcessor2_0())

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Terakhir, seperti yang disarankan dalam Optimizations, mengaktifkan torch.compile dapat meningkatkan kinerja lebih lanjut tergantung pada perangkat keras target.
Namun, kompilasi menimbulkan overhead yang signifikan selama pemanggilan pipeline pertama, sehingga hanya menguntungkan ketika
instans pipeline yang sama dipanggil berulang kali, misalnya di dalam loop.
  import diffusers
  import torch
  from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  pipe.vae.set_attn_processor(AttnProcessor2_0())
  pipe.unet.set_attn_processor(AttnProcessor2_0())

+ pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Memaksimalkan Presisi dan Ensembling
Pipeline Marigold memiliki mekanisme ensembling bawaan yang menggabungkan beberapa prediksi dari latens acak yang berbeda.
Ini adalah cara brute-force untuk meningkatkan presisi prediksi, memanfaatkan sifat generatif dari difusi.
Jalur ensembling diaktifkan secara otomatis ketika argumen ensemble_size diatur lebih besar atau sama dengan 3.
Ketika bertujuan untuk presisi maksimum, masuk akal untuk menyesuaikan num_inference_steps secara bersamaan dengan ensemble_size.
Nilai yang direkomendasikan bervariasi di antara checkpoint, tetapi terutama bergantung pada jenis scheduler.
Efek ensembling terlihat sangat jelas pada surface normals:
  import diffusers

  pipe = diffusers.MarigoldNormalsPipeline.from_pretrained("prs-eth/marigold-normals-v1-1").to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=10, ensemble_size=5)

  vis = pipe.image_processor.visualize_normals(depth.prediction)
vis[0].save("einstein_normals.png") 
Seperti yang terlihat, semua area dengan struktur halus, seperti rambut, mendapatkan prediksi yang lebih konservatif dan rata-rata lebih benar. Hasil seperti ini lebih cocok untuk tugas turunan yang sensitif terhadap presisi, seperti rekonstruksi 3D.
Pemrosesan Video Per Bingkai dengan Konsistensi Temporal
Karena sifat generatif Marigold, setiap prediksi bersifat unik dan didefinisikan oleh noise acak yang disampelkan untuk inisialisasi laten. Hal ini menjadi kelemahan yang jelas dibandingkan dengan jaringan regresi padat end-to-end tradisional, seperti yang ditunjukkan dalam video-video berikut:


Untuk mengatasi masalah ini, Anda dapat melewatkan argumen latents ke pipeline, yang menentukan titik awal difusi.
Secara empiris, kami menemukan bahwa kombinasi konveks dari noise latent titik awal yang sama persis dengan latent yang sesuai dengan prediksi frame sebelumnya menghasilkan hasil yang cukup halus, seperti yang diimplementasikan dalam potongan kode di bawah:
import imageio
import diffusers
import torch
from diffusers.models.attention_processor import AttnProcessor2_0
from PIL import Image
from tqdm import tqdm

device = "cuda"  # or "mps", "xpu", "cpu"
path_in = "https://huggingface.co/spaces/prs-eth/marigold-lcm/resolve/c7adb5427947d2680944f898cd91d386bf0d4924/files/video/obama.mp4"
path_out = "obama_depth.gif"

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to(device)
pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
    "madebyollin/taesd", dtype=torch.float16
).to(device)
pipe.unet.set_attn_processor(AttnProcessor2_0())
pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
pipe.set_progress_bar_config(disable=True)

with imageio.get_reader(path_in) as reader:
    size = reader.get_meta_data()['size']
    last_frame_latent = None
    latent_common = torch.randn(
        (1, 4, 768 * size[1] // (8 * max(size)), 768 * size[0] // (8 * max(size)))
    ).to(device=device, dtype=torch.float16)

    out = []
    for frame_id, frame in tqdm(enumerate(reader), desc="Processing Video"):
        frame = Image.fromarray(frame)
        latents = latent_common
        if last_frame_latent is not None:
            latents = 0.9 * latents + 0.1 * last_frame_latent

        depth = pipe(
            frame,
            num_inference_steps=1,
            match_input_resolution=False,
            latents=latents,
            output_latent=True,
        )
        last_frame_latent = depth.latent
        out.append(pipe.image_processor.visualize_depth(depth.prediction)[0])

    diffusers.utils.export_to_gif(out, path_out, fps=reader.get_meta_data()['fps'])
Di sini, proses difusi dimulai dari laten yang telah dihitung.
Pipeline mengatur output_latent=True untuk mengakses out.latent dan menghitung kontribusinya terhadap inisialisasi laten frame berikutnya.
Hasilnya jauh lebih stabil sekarang:

Marigold untuk ControlNet
Aplikasi yang sangat umum untuk prediksi kedalaman dengan model difusi adalah dalam kombinasi dengan ControlNet. Ketajaman kedalaman memainkan peran penting dalam memperoleh hasil berkualitas tinggi dari ControlNet. Seperti yang terlihat pada perbandingan dengan metode lain di atas, Marigold unggul dalam tugas tersebut. Potongan kode di bawah ini menunjukkan cara memuat gambar, menghitung kedalaman, dan meneruskannya ke ControlNet dalam format yang kompatibel:
import torch
import diffusers

device = "cuda"  # or "mps", "xpu", "cpu"
generator = torch.Generator(device=device).manual_seed(2024)
image = diffusers.utils.load_image(
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/controlnet_depth_source.png"
)

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", dtype=torch.float16, variant="fp16"
).to(device)

depth_image = pipe(image, generator=generator).prediction
depth_image = pipe.image_processor.visualize_depth(depth_image, color_map="binary")
depth_image[0].save("motorcycle_controlnet_depth.png")

controlnet = diffusers.ControlNetModel.from_pretrained(
    "diffusers/controlnet-depth-sdxl-1.0", dtype=torch.float16, variant="fp16"
).to(device)
pipe = diffusers.StableDiffusionXLControlNetPipeline.from_pretrained(
    "SG161222/RealVisXL_V4.0", dtype=torch.float16, variant="fp16", controlnet=controlnet
).to(device)
pipe.scheduler = diffusers.DPMSolverMultistepScheduler.from_config(pipe.scheduler.config, use_karras_sigmas=True)

controlnet_out = pipe(
    prompt="high quality photo of a sports bike, city",
    negative_prompt="",
    guidance_scale=6.5,
    num_inference_steps=25,
    image=depth_image,
    controlnet_conditioning_scale=0.7,
    control_guidance_end=0.7,
    generator=generator,
).images
controlnet_out[0].save("motorcycle_controlnet_out.png")


Evaluasi Kuantitatif
Untuk mengevaluasi Marigold secara kuantitatif di leaderboard dan benchmark standar (seperti NYU, KITTI, dan dataset lainnya),
ikuti protokol evaluasi yang diuraikan dalam makalah: muat model presisi penuh fp32 dan gunakan nilai yang sesuai
untuk num_inference_steps dan ensemble_size.
Secara opsional, tetapkan seed ke acak untuk memastikan reproduktibilitas.
Memaksimalkan batch_size akan memberikan pemanfaatan perangkat yang maksimal.
import diffusers
import torch

device = "cuda"  # or "mps", "xpu", "cpu"
seed = 2024

generator = torch.Generator(device=device).manual_seed(seed)
pipe = diffusers.MarigoldDepthPipeline.from_pretrained("prs-eth/marigold-depth-v1-1").to(device)

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
    image,
    num_inference_steps=4,  # set according to the evaluation protocol from the paper
    ensemble_size=10,       # set according to the evaluation protocol from the paper
    generator=generator,
)

# evaluate metrics
Menggunakan Ketidakpastian Prediktif
Mekanisme ensembling yang dibangun ke dalam pipeline Marigold menggabungkan beberapa prediksi yang diperoleh dari latens acak yang berbeda.
Sebagai efek samping, mekanisme ini dapat digunakan untuk mengkuantifikasi ketidakpastian epistemik (model); cukup tentukan ensemble_size yang lebih besar atau sama dengan 3 dan atur output_uncertainty=True.
Ketidakpastian yang dihasilkan akan tersedia di field uncertainty dari output.
Hal ini dapat divisualisasikan sebagai berikut:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
	image,
	ensemble_size=10,  # any number >= 3
	output_uncertainty=True,
)

uncertainty = pipe.image_processor.visualize_uncertainty(depth.uncertainty)
uncertainty[0].save("einstein_depth_uncertainty.png")


Interpretasi ketidakpastian mudah: nilai yang lebih tinggi (putih) sesuai dengan piksel, di mana model kesulitan membuat prediksi yang konsisten.
- Model kedalaman menunjukkan ketidakpastian tertinggi di sekitar diskontinuitas, di mana kedalaman objek berubah secara tiba-tiba.
- Model normal permukaan paling tidak yakin pada struktur berbutir halus seperti rambut dan pada area gelap seperti bagian kerah.
- Ketidakpastian albedo direpresentasikan sebagai gambar RGB, karena ia menangkap ketidakpastian secara independen untuk setiap kanal warna, berbeda dengan kedalaman dan normal permukaan. Nilainya juga lebih tinggi di area yang berbayang dan pada diskontinuitas.
API Prediksi Kedalaman Marigold
kelas diffusers.MarigoldDepthPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonescale_invariant: bool | None = Trueshift_invariant: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Parameter
- unet (
UNet2DConditionModel) — U-Net bersyarat untuk mendenois latent kedalaman, dikondisikan pada latent gambar. - vae (
AutoencoderKL) — Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar serta prediksi ke dan dari representasi laten. - scheduler (
DDIMScheduleratauLCMScheduler) — Scheduler yang digunakan bersamaunetuntuk menghilangkan noise pada latens gambar yang telah dikodekan. - text_encoder (
CLIPTextModel) — Text-encoder, untuk embedding teks kosong. - tokenizer (
CLIPTokenizer) — Tokenizer CLIP. - prediction_type (
str, opsional) — Jenis prediksi yang dibuat oleh model. - scale_invariant (
bool, opsional) — Properti model yang menentukan apakah peta kedalaman yang diprediksi bersifat skala-invarian. Nilai ini harus diatur dalam konfigurasi model. Ketika digunakan bersama dengan flagshift_invariant=True, model juga disebut “afin-invarian”. Catatan: menimpa nilai ini tidak didukung. - shift_invariant (
bool, opsional) — Properti model yang menentukan apakah peta kedalaman yang diprediksi bersifat shift-invariant. Nilai ini harus diatur dalam konfigurasi model. Ketika digunakan bersama dengan flagscale_invariant=True, model tersebut juga disebut “affine-invariant”. Catatan: menimpa nilai ini tidak didukung. - default_denoising_steps (
int, opsional) — Jumlah minimum langkah difusi denoising yang diperlukan untuk menghasilkan prediksi dengan kualitas yang wajar menggunakan model yang diberikan. Nilai ini harus diatur dalam konfigurasi model. Ketika pipeline dipanggil tanpa secara eksplisit mengaturnum_inference_steps, nilai default akan digunakan. Hal ini diperlukan untuk memastikan hasil yang wajar dengan berbagai varian model yang kompatibel dengan pipeline, seperti yang mengandalkan jadwal denoising yang sangat singkat (LCMScheduler) dan yang memiliki jadwal difusi penuh (DDIMScheduler). - default_processing_resolution (
int, opsional) — Nilai yang direkomendasikan untuk parameterprocessing_resolutiondari pipeline. Nilai ini harus diatur dalam konfigurasi model. Ketika pipeline dipanggil tanpa mengaturprocessing_resolutionsecara eksplisit, nilai default akan digunakan. Hal ini diperlukan untuk memastikan hasil yang wajar dengan berbagai varian model yang dilatih dengan nilai resolusi pemrosesan optimal yang bervariasi.
Pipeline untuk estimasi kedalaman monokular menggunakan metode Marigold: https://marigoldmonodepth.github.io.
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldDepthOutput or tuple
Parameter
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]),list[torch.Tensor]: Gambar input atau beberapa gambar yang digunakan sebagai input untuk tugas estimasi kedalaman. Untuk array dan tensor, rentang nilai yang diharapkan adalah antara[0, 1]. Mengirimkan batch gambar dimungkinkan dengan menyediakan array atau tensor berdimensi empat. Selain itu, daftar gambar berupa array atau tensor berdimensi dua atau tiga juga dapat dikirimkan. Dalam kasus terakhir, semua elemen daftar harus memiliki lebar dan tinggi yang sama. - num_inference_steps (
int, opsional, defaultnyaNone) — Jumlah langkah denoising difusi selama inferensi. Nilai defaultNonemenghasilkan pemilihan otomatis. - ensemble_size (
int, defaultnya1) — Jumlah prediksi ensemble. Nilai yang lebih tinggi menghasilkan peningkatan yang terukur dan degradasi visual. - processing_resolution (
int, opsional, defaultnyaNone) — Resolusi pemrosesan efektif. Ketika diset ke0, sesuai dengan dimensi gambar input yang lebih besar. Hal ini menghasilkan prediksi yang lebih tajam, tetapi juga dapat menyebabkan hilangnya konteks global secara keseluruhan. Nilai defaultNonediselesaikan ke nilai optimal dari konfigurasi model. - match_input_resolution (
bool, opsional, defaultnyaTrue) — Saat diaktifkan, prediksi output di-resize agar sesuai dengan dimensi input. Saat dinonaktifkan, sisi terpanjang dari output akan sama denganprocessing_resolution. - resample_method_input (
str, opsional, defaultnya"bilinear") — Metode resampling yang digunakan untuk mengubah ukuran gambar input menjadiprocessing_resolution. Nilai yang diterima adalah:"nearest","nearest-exact","bilinear","bicubic", atau"area". - resample_method_output (
str, opsional, default"bilinear") — Metode resampling yang digunakan untuk mengubah ukuran prediksi output agar sesuai dengan resolusi input. Nilai yang diterima adalah"nearest","nearest-exact","bilinear","bicubic", atau"area". - batch_size (
int, opsional, defaultnya1) — Ukuran batch; hanya relevan saat mengaturensemble_sizeatau meneruskan tensor gambar. - ensembling_kwargs (
dict, opsional, defaultnyaNone) — Kamus tambahan berisi argumen untuk kontrol ensembling yang presisi. Opsi berikut tersedia:- reduction (
str, opsional, default"median"): Mendefinisikan fungsi ensembling yang diterapkan di setiap lokasi piksel, dapat berupa"median"atau"mean". - regularizer_strength (
float, opsional, default0.02): Kekuatan regularizer yang menarik prediksi yang telah diselaraskan ke rentang unit dari 0 hingga 1. - max_iter (
int, opsional, default2): Jumlah maksimum langkah solver alignment. Lihat fungsiscipy.optimize.minimize, argumenoptions. - tol (
float, opsional, default1e-3): Toleransi solver alignment. Solver berhenti ketika toleransi tercapai. - max_res (
int, opsional, defaultnyaNone): Resolusi di mana penyesuaian dilakukan;Nonesesuai denganprocessing_resolution.
- reduction (
- latents (
torch.Tensor, ataulist[torch.Tensor], opsional, defaultNone) — Tensor noise laten untuk menggantikan inisialisasi acak. Tensor ini dapat diambil dari output panggilan fungsi sebelumnya. - generator (
torch.Generator, ataulist[torch.Generator], opsional, defaultNone) — Objek generator angka acak untuk memastikan reproduktibilitas. - output_type (
str, opsional, default"np") — Format yang diinginkan untukpredictiondan fielduncertaintyopsional dari output. Nilai yang diterima adalah:"np"(array numpy) atau"pt"(tensor torch). - output_uncertainty (
bool, opsional, defaultFalse) — Jika diaktifkan, fielduncertaintypada output berisi peta ketidakpastian prediktif, asalkan argumenensemble_sizediatur ke nilai di atas 2. - output_latent (
bool, opsional, defaultFalse) — Jika diaktifkan, fieldlatentpada output berisi kode laten yang sesuai dengan prediksi di dalam ensemble. Kode-kode ini dapat disimpan, dimodifikasi, dan digunakan untuk panggilan berikutnya dengan argumenlatents. - return_dict (
bool, opsional, defaultTrue) — Apakah akan mengembalikan MarigoldDepthOutput alih-alih tuple biasa.
Mengembalikan
MarigoldDepthOutput atau tuple
Jika return_dict adalah True, MarigoldDepthOutput dikembalikan, selain itu sebuah
tuple dikembalikan di mana elemen pertama adalah prediksi, elemen kedua adalah ketidakpastian
(atau None), dan elemen ketiga adalah laten (atau None).
Fungsi yang dipanggil saat memanggil pipeline.
Contoh:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
...     "prs-eth/marigold-depth-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> depth = pipe(image)

>>> vis = pipe.image_processor.visualize_depth(depth.prediction)
>>> vis[0].save("einstein_depth.png")

>>> depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
>>> depth_16bit[0].save("einstein_depth_16bit.png")
kelas diffusers.pipelines.marigold.MarigoldDepthOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Parameter
- prediction (
np.ndarray,torch.Tensor) — Peta kedalaman yang diprediksi dengan nilai dalam rentang [0, 1]. Bentuknya adalahnumimages × 1 × height × widthuntuktorch.Tensorataunumimages × height × width × 1untuknp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Peta ketidakpastian yang dihitung dari ensemble, dengan nilai dalam rentang [0, 1]. Bentuknya adalahnumimages × 1 × height × widthuntuktorch.Tensorataunumimages × height × width × 1untuknp.ndarray. - latent (
None,torch.Tensor) — Fitur laten yang sesuai dengan prediksi, kompatibel dengan argumenlatentsdari pipeline. Bentuknya adalahnumimages * numensemble × 4 × latentheight × latentwidth.
Kelas output untuk pipeline prediksi kedalaman monokular Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_depth
< source >( depth: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]val_min: float = 0.0val_max: float = 1.0color_map: str = 'Spectral' )
Parameter
- depth (
PIL.Image.Image | np.ndarray | torch.Tensor | list[PIL.Image.Image, list[np.ndarray], -- list[torch.Tensor]]): Peta kedalaman. - val_min (
float, opsional, default0.0) — Nilai minimum dari rentang kedalaman yang divisualisasikan. - val_max (
float, opsional, default1.0) — Nilai maksimum dari rentang kedalaman yang divisualisasikan. - color_map (
str, opsional, default"Spectral") — Color map yang digunakan untuk mengubah prediksi kedalaman satu kanal menjadi representasi berwarna.
Memvisualisasikan peta kedalaman, seperti prediksi dari MarigoldDepthPipeline.
Mengembalikan: list[PIL.Image.Image] berisi visualisasi peta kedalaman.
API Estimasi Normal Marigold
kelas diffusers.MarigoldNormalsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Noneuse_full_z_range: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Parameter
- unet (
UNet2DConditionModel) — U-Net bersyarat untuk mendenois latent normal, dikondisikan pada latent gambar. - vae (
AutoencoderKL) — Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar serta prediksi ke dan dari representasi laten. - scheduler (
DDIMScheduleratauLCMScheduler) — Scheduler yang digunakan bersamaunetuntuk menghilangkan noise pada latens gambar yang telah dikodekan. - text_encoder (
CLIPTextModel) — Text-encoder, untuk embedding teks kosong. - tokenizer (
CLIPTokenizer) — Tokenizer CLIP. - prediction_type (
str, opsional) — Jenis prediksi yang dibuat oleh model. - use_full_z_range (
bool, opsional) — Apakah normal yang diprediksi oleh model ini memanfaatkan rentang penuh dimensi Z, atau hanya separuh positifnya. - default_denoising_steps (
int, opsional) — Jumlah minimum langkah difusi denoising yang diperlukan untuk menghasilkan prediksi dengan kualitas yang wajar menggunakan model yang diberikan. Nilai ini harus diatur dalam konfigurasi model. Ketika pipeline dipanggil tanpa secara eksplisit mengaturnum_inference_steps, nilai default akan digunakan. Hal ini diperlukan untuk memastikan hasil yang wajar dengan berbagai varian model yang kompatibel dengan pipeline, seperti yang mengandalkan jadwal denoising yang sangat singkat (LCMScheduler) dan yang memiliki jadwal difusi penuh (DDIMScheduler). - default_processing_resolution (
int, opsional) — Nilai yang direkomendasikan untuk parameterprocessing_resolutiondari pipeline. Nilai ini harus diatur dalam konfigurasi model. Ketika pipeline dipanggil tanpa mengaturprocessing_resolutionsecara eksplisit, nilai default akan digunakan. Hal ini diperlukan untuk memastikan hasil yang wajar dengan berbagai varian model yang dilatih dengan nilai resolusi pemrosesan optimal yang bervariasi.
Pipeline untuk estimasi normal monokular menggunakan metode Marigold: https://marigoldmonodepth.github.io.
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldNormalsOutput or tuple
Parameter
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]), —list[torch.Tensor]: Gambar input atau beberapa gambar yang digunakan sebagai input untuk tugas estimasi normal. Untuk array dan tensor, rentang nilai yang diharapkan adalah antara[0, 1]. Mengirimkan batch gambar dimungkinkan dengan menyediakan array atau tensor berdimensi empat. Selain itu, daftar gambar berupa array atau tensor berdimensi dua atau tiga juga dapat dikirimkan. Dalam kasus terakhir, semua elemen daftar harus memiliki lebar dan tinggi yang sama. - num_inference_steps (
int, opsional, defaultnyaNone) — Jumlah langkah denoising difusi selama inferensi. Nilai defaultNonemenghasilkan pemilihan otomatis. - ensemble_size (
int, defaultnya1) — Jumlah prediksi ensemble. Nilai yang lebih tinggi menghasilkan peningkatan yang terukur dan degradasi visual. - processing_resolution (
int, opsional, defaultnyaNone) — Resolusi pemrosesan efektif. Ketika diset ke0, sesuai dengan dimensi gambar input yang lebih besar. Hal ini menghasilkan prediksi yang lebih tajam, tetapi juga dapat menyebabkan hilangnya konteks global secara keseluruhan. Nilai defaultNonediselesaikan ke nilai optimal dari konfigurasi model. - match_input_resolution (
bool, opsional, defaultnyaTrue) — Saat diaktifkan, prediksi output di-resize agar sesuai dengan dimensi input. Saat dinonaktifkan, sisi terpanjang dari output akan sama denganprocessing_resolution. - resample_method_input (
str, opsional, defaultnya"bilinear") — Metode resampling yang digunakan untuk mengubah ukuran gambar input menjadiprocessing_resolution. Nilai yang diterima adalah:"nearest","nearest-exact","bilinear","bicubic", atau"area". - resample_method_output (
str, opsional, default"bilinear") — Metode resampling yang digunakan untuk mengubah ukuran prediksi output agar sesuai dengan resolusi input. Nilai yang diterima adalah"nearest","nearest-exact","bilinear","bicubic", atau"area". - batch_size (
int, opsional, defaultnya1) — Ukuran batch; hanya relevan saat mengaturensemble_sizeatau meneruskan tensor gambar. - ensembling_kwargs (
dict, opsional, defaultnyaNone) — Kamus tambahan berisi argumen untuk kontrol ensembling yang presisi. Opsi berikut tersedia:- reduction (
str, opsional, default"closest"): Mendefinisikan fungsi ensembling yang diterapkan di setiap lokasi piksel, dapat berupa"closest"atau"mean".
- reduction (
- latents (
torch.Tensor, opsional, defaultNone) — Tensor noise laten untuk menggantikan inisialisasi acak. Tensor ini dapat diambil dari output panggilan fungsi sebelumnya. - generator (
torch.Generator, ataulist[torch.Generator], opsional, defaultNone) — Objek generator angka acak untuk memastikan reproduktibilitas. - output_type (
str, opsional, default"np") — Format yang diinginkan untukpredictiondan fielduncertaintyopsional dari output. Nilai yang diterima adalah:"np"(array numpy) atau"pt"(tensor torch). - output_uncertainty (
bool, opsional, defaultFalse) — Jika diaktifkan, fielduncertaintypada output berisi peta ketidakpastian prediktif, asalkan argumenensemble_sizediatur ke nilai di atas 2. - output_latent (
bool, opsional, defaultFalse) — Jika diaktifkan, fieldlatentpada output berisi kode laten yang sesuai dengan prediksi di dalam ensemble. Kode-kode ini dapat disimpan, dimodifikasi, dan digunakan untuk panggilan berikutnya dengan argumenlatents. - return_dict (
bool, opsional, defaultTrue) — Apakah akan mengembalikan MarigoldNormalsOutput alih-alih tuple biasa.
Mengembalikan
MarigoldNormalsOutput atau tuple
Jika return_dict adalah True, MarigoldNormalsOutput dikembalikan, selain itu sebuah
tuple dikembalikan di mana elemen pertama adalah prediksi, elemen kedua adalah ketidakpastian
(atau None), dan elemen ketiga adalah laten (atau None).
Fungsi yang dipanggil saat memanggil pipeline.
Contoh:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
...     "prs-eth/marigold-normals-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> normals = pipe(image)

>>> vis = pipe.image_processor.visualize_normals(normals.prediction)
>>> vis[0].save("einstein_normals.png")
kelas diffusers.pipelines.marigold.MarigoldNormalsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Parameter
- prediction (
np.ndarray,torch.Tensor) — Normal yang diprediksi dengan nilai dalam rentang [-1, 1]. Bentuknya adalahnumimages × 3 × height × widthuntuktorch.Tensorataunumimages × height × width × 3untuknp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Peta ketidakpastian yang dihitung dari ensemble, dengan nilai dalam rentang [0, 1]. Bentuknya adalahnumimages × 1 × height × widthuntuktorch.Tensorataunumimages × height × width × 1untuknp.ndarray. - latent (
None,torch.Tensor) — Fitur laten yang sesuai dengan prediksi, kompatibel dengan argumenlatentsdari pipeline. Bentuknya adalahnumimages * numensemble × 4 × latentheight × latentwidth.
Kelas output untuk pipeline prediksi normal monokular Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_normals
< source >( normals: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]flip_x: bool = Falseflip_y: bool = Falseflip_z: bool = False )
Parameter
- normals (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Normal permukaan. - flip_x (
bool, opsional, defaultFalse) — Membalikkan sumbu X dari kerangka acuan normal. Arah default adalah ke kanan. - flip_y (
bool, opsional, defaultFalse) — Membalikkan sumbu Y dari kerangka acuan normal. Arah default adalah ke atas. - flip_z (
bool, opsional, defaultFalse) — Membalikkan sumbu Z dari kerangka acuan normal. Arah default menghadap pengamat.
Memvisualisasikan normal permukaan, seperti prediksi dari MarigoldNormalsPipeline.
Mengembalikan: list[PIL.Image.Image] dengan visualisasi normal permukaan.
API Dekomposisi Gambar Intrinsic Marigold
kelas diffusers.MarigoldIntrinsicsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonetarget_properties: dict[str, typing.Any] | None = Nonedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Parameter
- unet (
UNet2DConditionModel) — U-Net bersyarat untuk mendenois target laten, dikondisikan pada laten gambar. - vae (
AutoencoderKL) — Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar serta prediksi ke dan dari representasi laten. - scheduler (
DDIMScheduleratauLCMScheduler) — Scheduler yang digunakan bersamaunetuntuk menghilangkan noise pada latens gambar yang telah dikodekan. - text_encoder (
CLIPTextModel) — Text-encoder, untuk embedding teks kosong. - tokenizer (
CLIPTokenizer) — Tokenizer CLIP. - prediction_type (
str, opsional) — Jenis prediksi yang dibuat oleh model. - target_properties (
dict[str, Any], opsional) — Properti dari modalitas yang diprediksi, sepertitarget_names, sebuahlist[str]yang digunakan untuk menentukan jumlah, urutan, dan nama dari modalitas yang diprediksi, serta metadata lain yang mungkin diperlukan untuk menafsirkan prediksi tersebut. - default_denoising_steps (
int, opsional) — Jumlah minimum langkah difusi denoising yang diperlukan untuk menghasilkan prediksi dengan kualitas yang wajar menggunakan model yang diberikan. Nilai ini harus diatur dalam konfigurasi model. Ketika pipeline dipanggil tanpa secara eksplisit mengaturnum_inference_steps, nilai default akan digunakan. Hal ini diperlukan untuk memastikan hasil yang wajar dengan berbagai varian model yang kompatibel dengan pipeline, seperti yang mengandalkan jadwal denoising yang sangat singkat (LCMScheduler) dan yang memiliki jadwal difusi penuh (DDIMScheduler). - default_processing_resolution (
int, opsional) — Nilai yang direkomendasikan untuk parameterprocessing_resolutiondari pipeline. Nilai ini harus diatur dalam konfigurasi model. Ketika pipeline dipanggil tanpa mengaturprocessing_resolutionsecara eksplisit, nilai default akan digunakan. Hal ini diperlukan untuk memastikan hasil yang wajar dengan berbagai varian model yang dilatih dengan nilai resolusi pemrosesan optimal yang bervariasi.
Pipeline untuk Dekomposisi Gambar Intrinsik (IID) menggunakan metode Marigold: https://marigoldcomputervision.github.io.
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldIntrinsicsOutput or tuple
Parameter
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]),list[torch.Tensor]: Gambar input atau beberapa gambar yang digunakan sebagai input untuk tugas dekomposisi intrinsik. Untuk array dan tensor, rentang nilai yang diharapkan adalah antara[0, 1]. Mengirimkan batch gambar dimungkinkan dengan menyediakan array atau tensor berdimensi empat. Selain itu, daftar gambar berupa array atau tensor berdimensi dua atau tiga juga dapat dikirimkan. Dalam kasus terakhir, semua elemen daftar harus memiliki lebar dan tinggi yang sama. - num_inference_steps (
int, opsional, defaultnyaNone) — Jumlah langkah denoising difusi selama inferensi. Nilai defaultNonemenghasilkan pemilihan otomatis. - ensemble_size (
int, defaultnya1) — Jumlah prediksi ensemble. Nilai yang lebih tinggi menghasilkan peningkatan yang terukur dan degradasi visual. - processing_resolution (
int, opsional, defaultnyaNone) — Resolusi pemrosesan efektif. Ketika diset ke0, sesuai dengan dimensi gambar input yang lebih besar. Hal ini menghasilkan prediksi yang lebih tajam, tetapi juga dapat menyebabkan hilangnya konteks global secara keseluruhan. Nilai defaultNonediselesaikan ke nilai optimal dari konfigurasi model. - match_input_resolution (
bool, opsional, defaultnyaTrue) — Saat diaktifkan, prediksi output di-resize agar sesuai dengan dimensi input. Saat dinonaktifkan, sisi terpanjang dari output akan sama denganprocessing_resolution. - resample_method_input (
str, opsional, defaultnya"bilinear") — Metode resampling yang digunakan untuk mengubah ukuran gambar input menjadiprocessing_resolution. Nilai yang diterima adalah:"nearest","nearest-exact","bilinear","bicubic", atau"area". - resample_method_output (
str, opsional, default"bilinear") — Metode resampling yang digunakan untuk mengubah ukuran prediksi output agar sesuai dengan resolusi input. Nilai yang diterima adalah"nearest","nearest-exact","bilinear","bicubic", atau"area". - batch_size (
int, opsional, defaultnya1) — Ukuran batch; hanya relevan saat mengaturensemble_sizeatau meneruskan tensor gambar. - ensembling_kwargs (
dict, opsional, defaultnyaNone) — Kamus tambahan berisi argumen untuk kontrol ensembling yang presisi. Opsi berikut tersedia:- reduction (
str, opsional, default"median"): Mendefinisikan fungsi ensembling yang diterapkan di setiap lokasi piksel, dapat berupa"median"atau"mean".
- reduction (
- latents (
torch.Tensor, opsional, defaultNone) — Tensor noise laten untuk menggantikan inisialisasi acak. Tensor ini dapat diambil dari output panggilan fungsi sebelumnya. - generator (
torch.Generator, ataulist[torch.Generator], opsional, defaultNone) — Objek generator angka acak untuk memastikan reproduktibilitas. - output_type (
str, opsional, default"np") — Format yang diinginkan untukpredictiondan fielduncertaintyopsional dari output. Nilai yang diterima adalah:"np"(array numpy) atau"pt"(tensor torch). - output_uncertainty (
bool, opsional, defaultFalse) — Jika diaktifkan, fielduncertaintypada output berisi peta ketidakpastian prediktif, asalkan argumenensemble_sizediatur ke nilai di atas 2. - output_latent (
bool, opsional, defaultFalse) — Jika diaktifkan, fieldlatentpada output berisi kode laten yang sesuai dengan prediksi di dalam ensemble. Kode-kode ini dapat disimpan, dimodifikasi, dan digunakan untuk panggilan berikutnya dengan argumenlatents. - return_dict (
bool, opsional, defaultTrue) — Apakah akan mengembalikan MarigoldIntrinsicsOutput alih-alih tuple biasa.
Mengembalikan
MarigoldIntrinsicsOutput atau tuple
Jika return_dict adalah True, MarigoldIntrinsicsOutput dikembalikan, selain itu sebuah
tuple dikembalikan di mana elemen pertama adalah prediksi, elemen kedua adalah ketidakpastian
(atau None), dan elemen ketiga adalah laten (atau None).
Fungsi yang dipanggil saat memanggil pipeline.
Contoh:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
...     "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)

>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["roughness"].save("einstein_roughness.png")
>>> vis[0]["metallicity"].save("einstein_metallicity.png")>>> import diffusers
>>> import torch
>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
... "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")
>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)
>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["shading"].save("einstein_shading.png")
>>> vis[0]["residual"].save("einstein_residual.png")kelas diffusers.pipelines.marigold.MarigoldIntrinsicsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Parameter
- prediction (
np.ndarray,torch.Tensor) — Intrinsik gambar yang diprediksi dengan nilai dalam rentang [0, 1]. Bentuknya adalah(numimages * numtargets) × 3 × height × widthuntuktorch.Tensoratau(numimages * numtargets) × height × width × 3untuknp.ndarray, di mananumtargetssesuai dengan jumlah modalitas target yang diprediksi dari dekomposisi gambar intrinsik. - uncertainty (
None,np.ndarray,torch.Tensor) — Peta ketidakpastian yang dihitung dari ensemble, dengan nilai dalam rentang [0, 1]. Bentuknya adalah(numimages * numtargets) × 3 × height × widthuntuktorch.Tensoratau(numimages * numtargets) × height × width × 3untuknp.ndarray. - latent (
None,torch.Tensor) — Fitur laten yang sesuai dengan prediksi, kompatibel dengan argumenlatentsdari pipeline. Bentuknya adalah(numimages * numensemble) × (numtargets * 4) × latentheight × latentwidth.
Kelas output untuk pipeline Marigold Intrinsic Image Decomposition.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_intrinsics
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]target_properties: dictcolor_map: str | dict[str, str] = 'binary' )
Parameter
- prediction (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Dekomposisi gambar intrinsik. - target_properties (
dict[str, Any]) — Properti dekomposisi. Entri yang diharapkan:target_names: list[str]dan kamus dengan kunciprediction_space: str,sub_target_names: list[str | Null](harus memiliki 3 entri, null untuk modalitas yang hilang),up_to_scale: bool, satu untuk setiap target dan sub-target. - color_map (
str | dict[str, str], opsional, default"Spectral") — Color map yang digunakan untuk mengubah prediksi satu kanal menjadi representasi berwarna. Ketika dictionary diberikan, setiap modalitas dapat diberi warna dengan color map-nya sendiri.
Memvisualisasikan dekomposisi gambar intrinsik, seperti prediksi dari MarigoldIntrinsicsPipeline.
Mengembalikan: list[dict[str, PIL.Image.Image]] dengan visualisasi dekomposisi gambar intrinsik.