
Diffusers documentation
OmniGen
OmniGen
OmniGen: Unified Image Generation de BAAI, par Shitao Xiao, Yueze Wang, Junjie Zhou, Huaying Yuan, Xingrun Xing, Ruiran Yan, Chaofan Li, Shuting Wang, Tiejun Huang, Zheng Liu.
L'abstract de l'article est :
L’émergence des grands modèles de langage (LLM) a unifié les tâches de génération de langage et révolutionné l’interaction homme-machine. Cependant, dans le domaine de la génération d’images, un modèle unifié capable de gérer diverses tâches au sein d’un seul cadre reste largement inexploré. Dans ce travail, nous présentons OmniGen, un nouveau modèle de diffusion pour la génération d’images unifiée. OmniGen se caractérise par les fonctionnalités suivantes : 1) Unification : OmniGen ne démontre pas seulement des capacités de génération d’images à partir de texte, mais prend également en charge de manière inhérente diverses tâches en aval, telles que l’édition d’images, la génération pilotée par un sujet et la génération conditionnelle visuelle. 2) Simplicité : L’architecture d’OmniGen est fortement simplifiée, éliminant le besoin de plugins supplémentaires. De plus, par rapport aux modèles de diffusion existants, il est plus convivial et peut accomplir des tâches complexes de bout en bout via des instructions, sans avoir besoin d’étapes intermédiaires supplémentaires, simplifiant ainsi considérablement le flux de travail de génération d’images. 3) Transfert de connaissances : Grâce à l’apprentissage dans un format unifié, OmniGen transfère efficacement les connaissances entre différentes tâches, gère les tâches et les domaines inconnus et présente des capacités novatrices. Nous explorons également les capacités de raisonnement du modèle et les applications potentielles du mécanisme de chaîne de pensée. Ce travail représente la première tentative de création d’un modèle de génération d’images à usage général, et nous publierons nos ressources sur https://github.com/VectorSpaceLab/OmniGen pour favoriser les avancées futures.
Pensez à consulter le guide des Schedulers pour apprendre à explorer le compromis entre la vitesse et la qualité du scheduler, et à consulter la section réutilisation des composants entre les pipelines pour apprendre à charger efficacement les mêmes composants dans plusieurs pipelines.
Ce pipeline a été contribué par staoxiao. La base de code originale peut être trouvée ici. Les poids originaux sont disponibles sous hf.co/shitao.
Charger les points de contrôle des modèles
Les poids du modèle peuvent être stockés dans des sous-dossiers distincts sur le Hub ou localement, auquel cas vous devez utiliser la méthode from_pretrained().
import torch
from diffusers import OmniGenPipeline

pipe = OmniGenPipeline.from_pretrained("Shitao/OmniGen-v1-diffusers", dtype=torch.bfloat16)
Texte vers image
Pour la génération d’images à partir de texte, transmettez un prompt texte. Par défaut, OmniGen génère une image de 1024x1024.
Vous pouvez essayer de définir les paramètres height et width pour générer des images de différentes tailles.
import torch
from diffusers import OmniGenPipeline

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "Realistic photo. A young woman sits on a sofa, holding a book and facing the camera. She wears delicate silver hoop earrings adorned with tiny, sparkling diamonds that catch the light, with her long chestnut hair cascading over her shoulders. Her eyes are focused and gentle, framed by long, dark lashes. She is dressed in a cozy cream sweater, which complements her warm, inviting smile. Behind her, there is a table with a cup of water in a sleek, minimalist blue mug. The background is a serene indoor setting with soft natural light filtering through a window, adorned with tasteful art and flowers, creating a cozy and peaceful ambiance. 4K, HD."
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    guidance_scale=3,
    generator=torch.Generator(device="cpu").manual_seed(111),
).images[0]
image.save("output.png")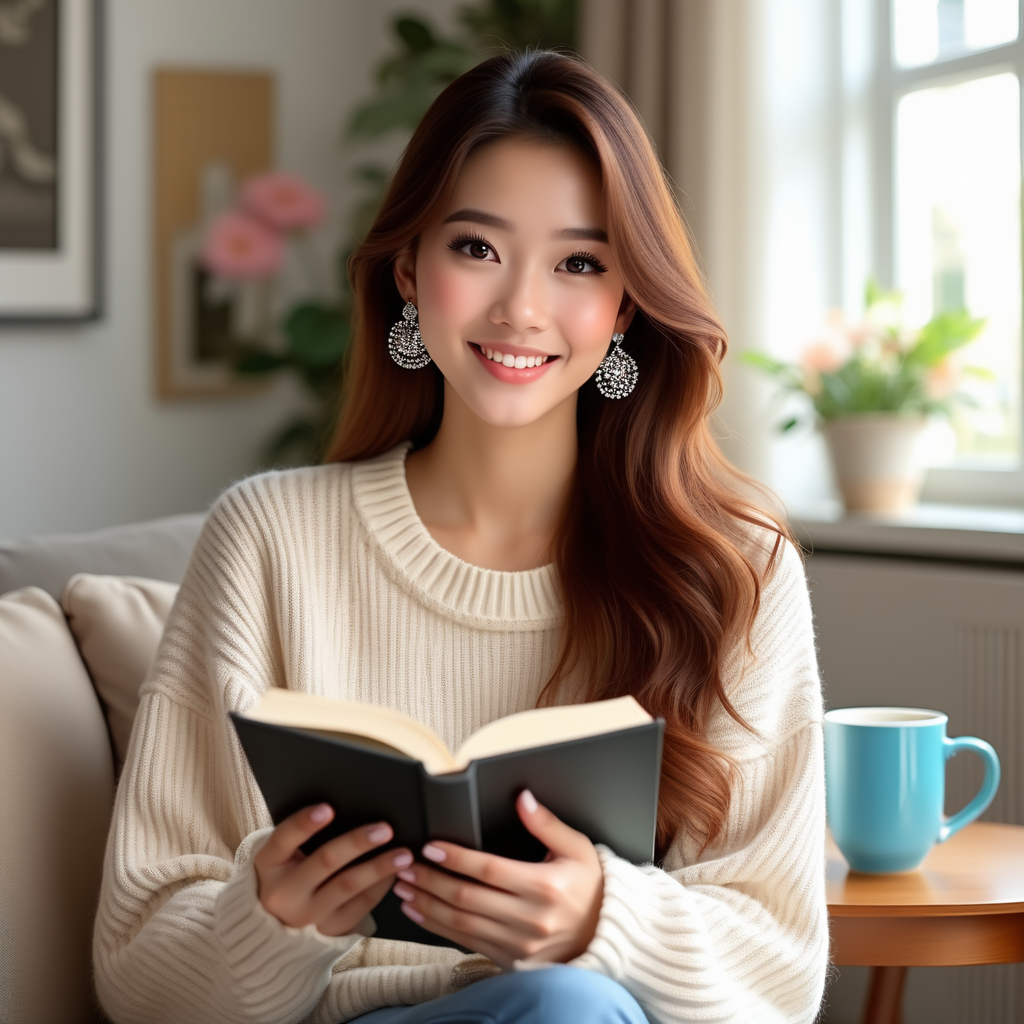
Édition d'image
OmniGen prend en charge les entrées multimodales.
Lorsque l’entrée inclut une image, vous devez ajouter un espace réservé <img><|image_1|></img> dans le prompt texte pour représenter l’image.
Il est recommandé d’activer use_input_image_size_as_output afin de conserver la même taille pour l’image modifiée que pour l’image d’origine.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="<img><|image_1|></img> Remove the woman's earrings. Replace the mug with a clear glass filled with sparkling iced cola."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/t2i_woman_with_book.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(222)
).images[0]
image.save("output.png") 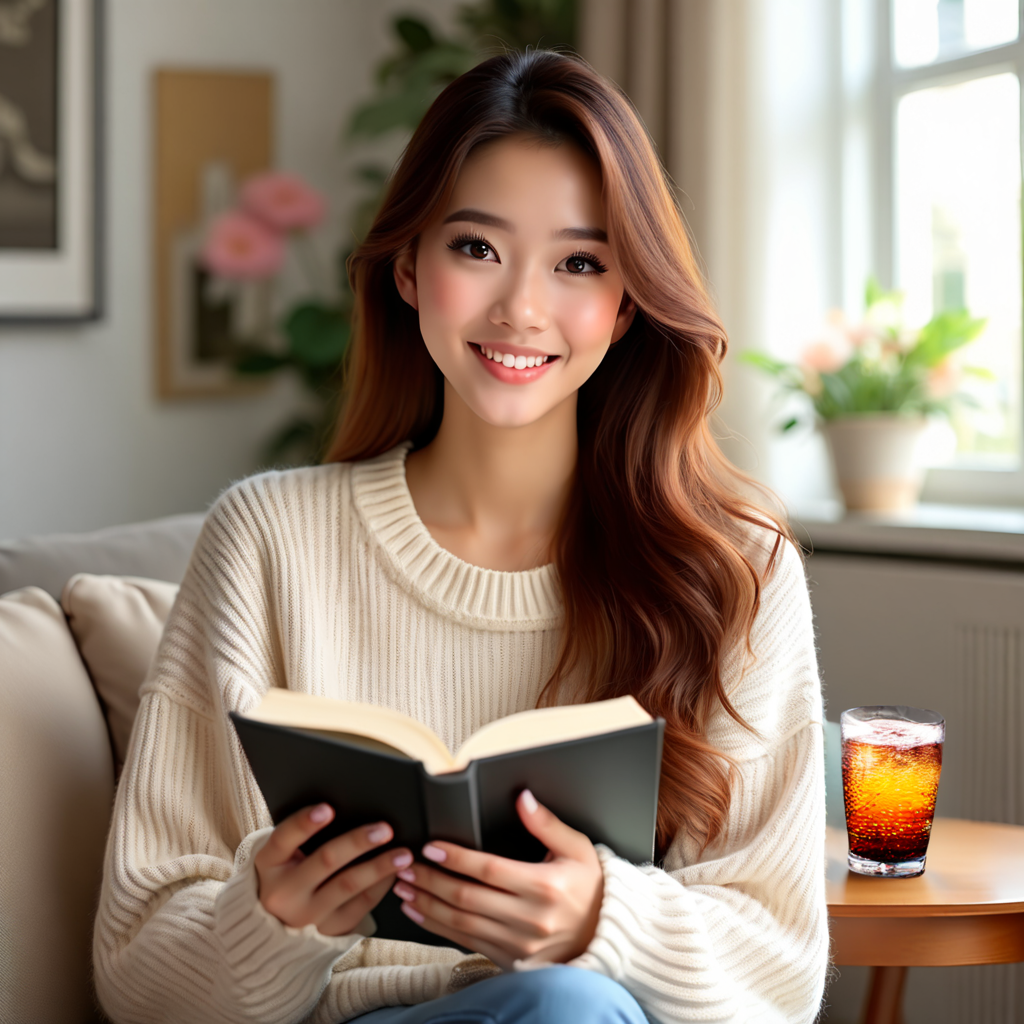
OmniGen possède certaines fonctionnalités intéressantes, telles que le raisonnement visuel, comme le montre l'exemple ci-dessous.
prompt="If the woman is thirsty, what should she take? Find it in the image and highlight it in blue. <img><|image_1|></img>"
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(0)
).images[0]
image.save("output.png")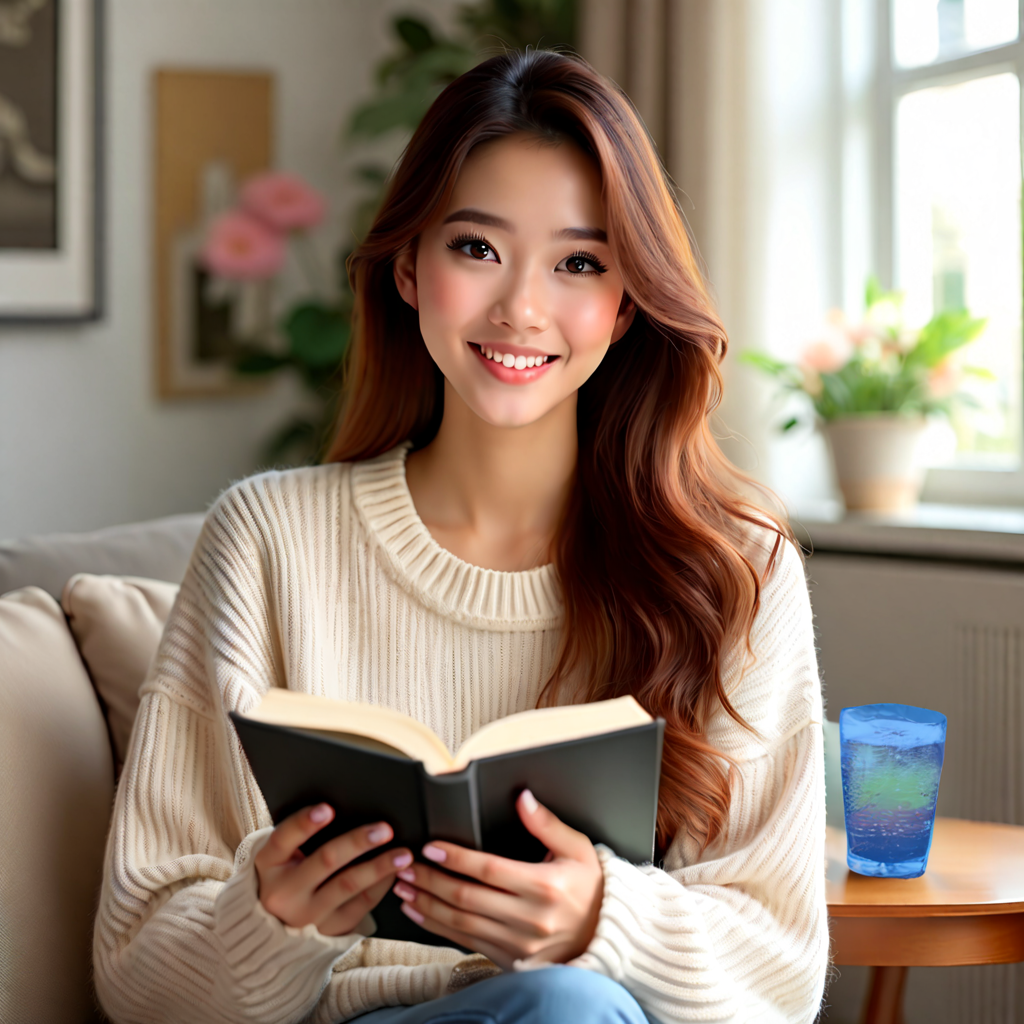
Génération contrôlable
OmniGen peut traiter plusieurs tâches classiques de vision par ordinateur. Comme indiqué ci-dessous, OmniGen peut détecter les squelettes humains dans les images d'entrée, ce qui peut être utilisé comme conditions de contrôle pour générer de nouvelles images.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="Detect the skeleton of human in this image: <img><|image_1|></img>"
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image1 = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(333)
).images[0]
image1.save("image1.png")

prompt="Generate a new photo using the following picture and text as conditions: <img><|image_1|></img>\n A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/skeletal.png")]
image2 = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(333)
).images[0]
image2.save("image2.png") 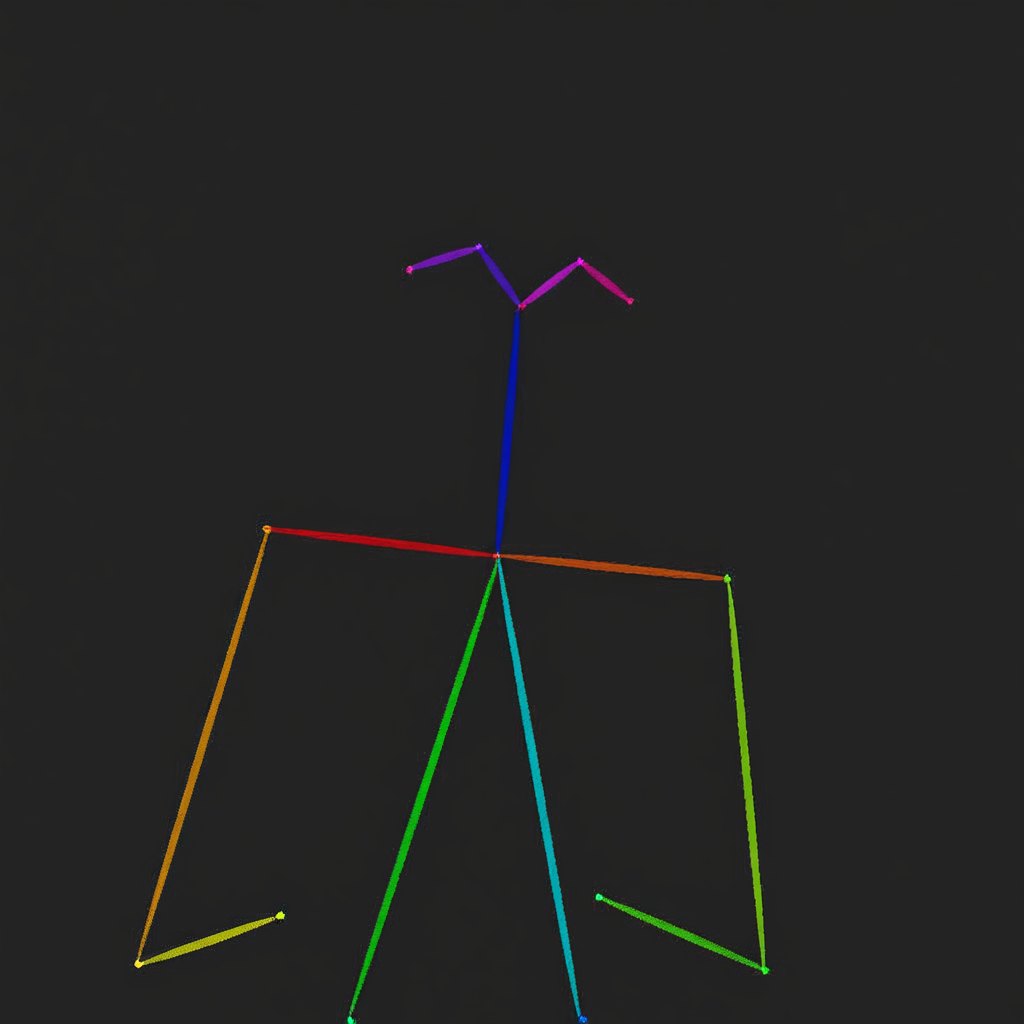
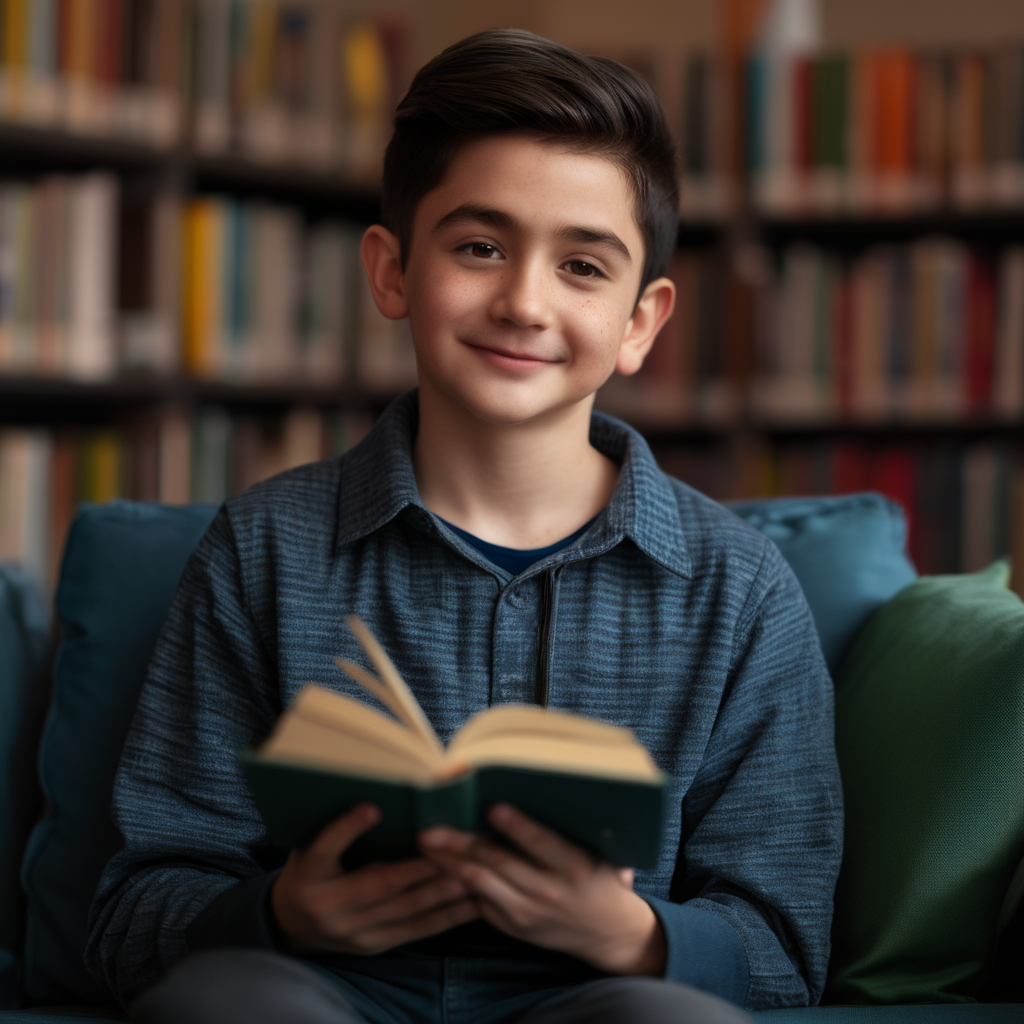
OmniGen peut également utiliser directement des informations pertinentes issues des images d'entrée pour générer de nouvelles images.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="Following the pose of this image <img><|image_1|></img>, generate a new photo: A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(0)
).images[0]
image.save("output.png")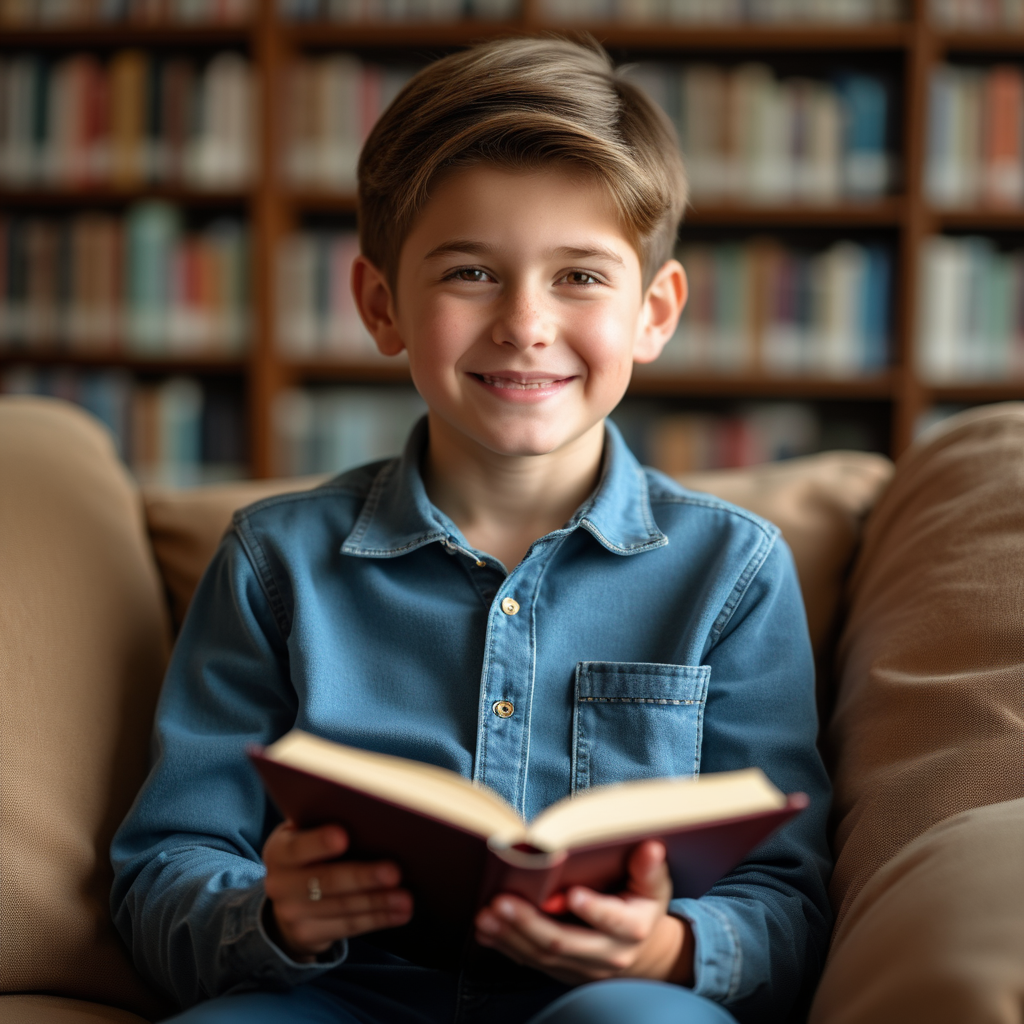
Préservation de l'ID et de l'objet
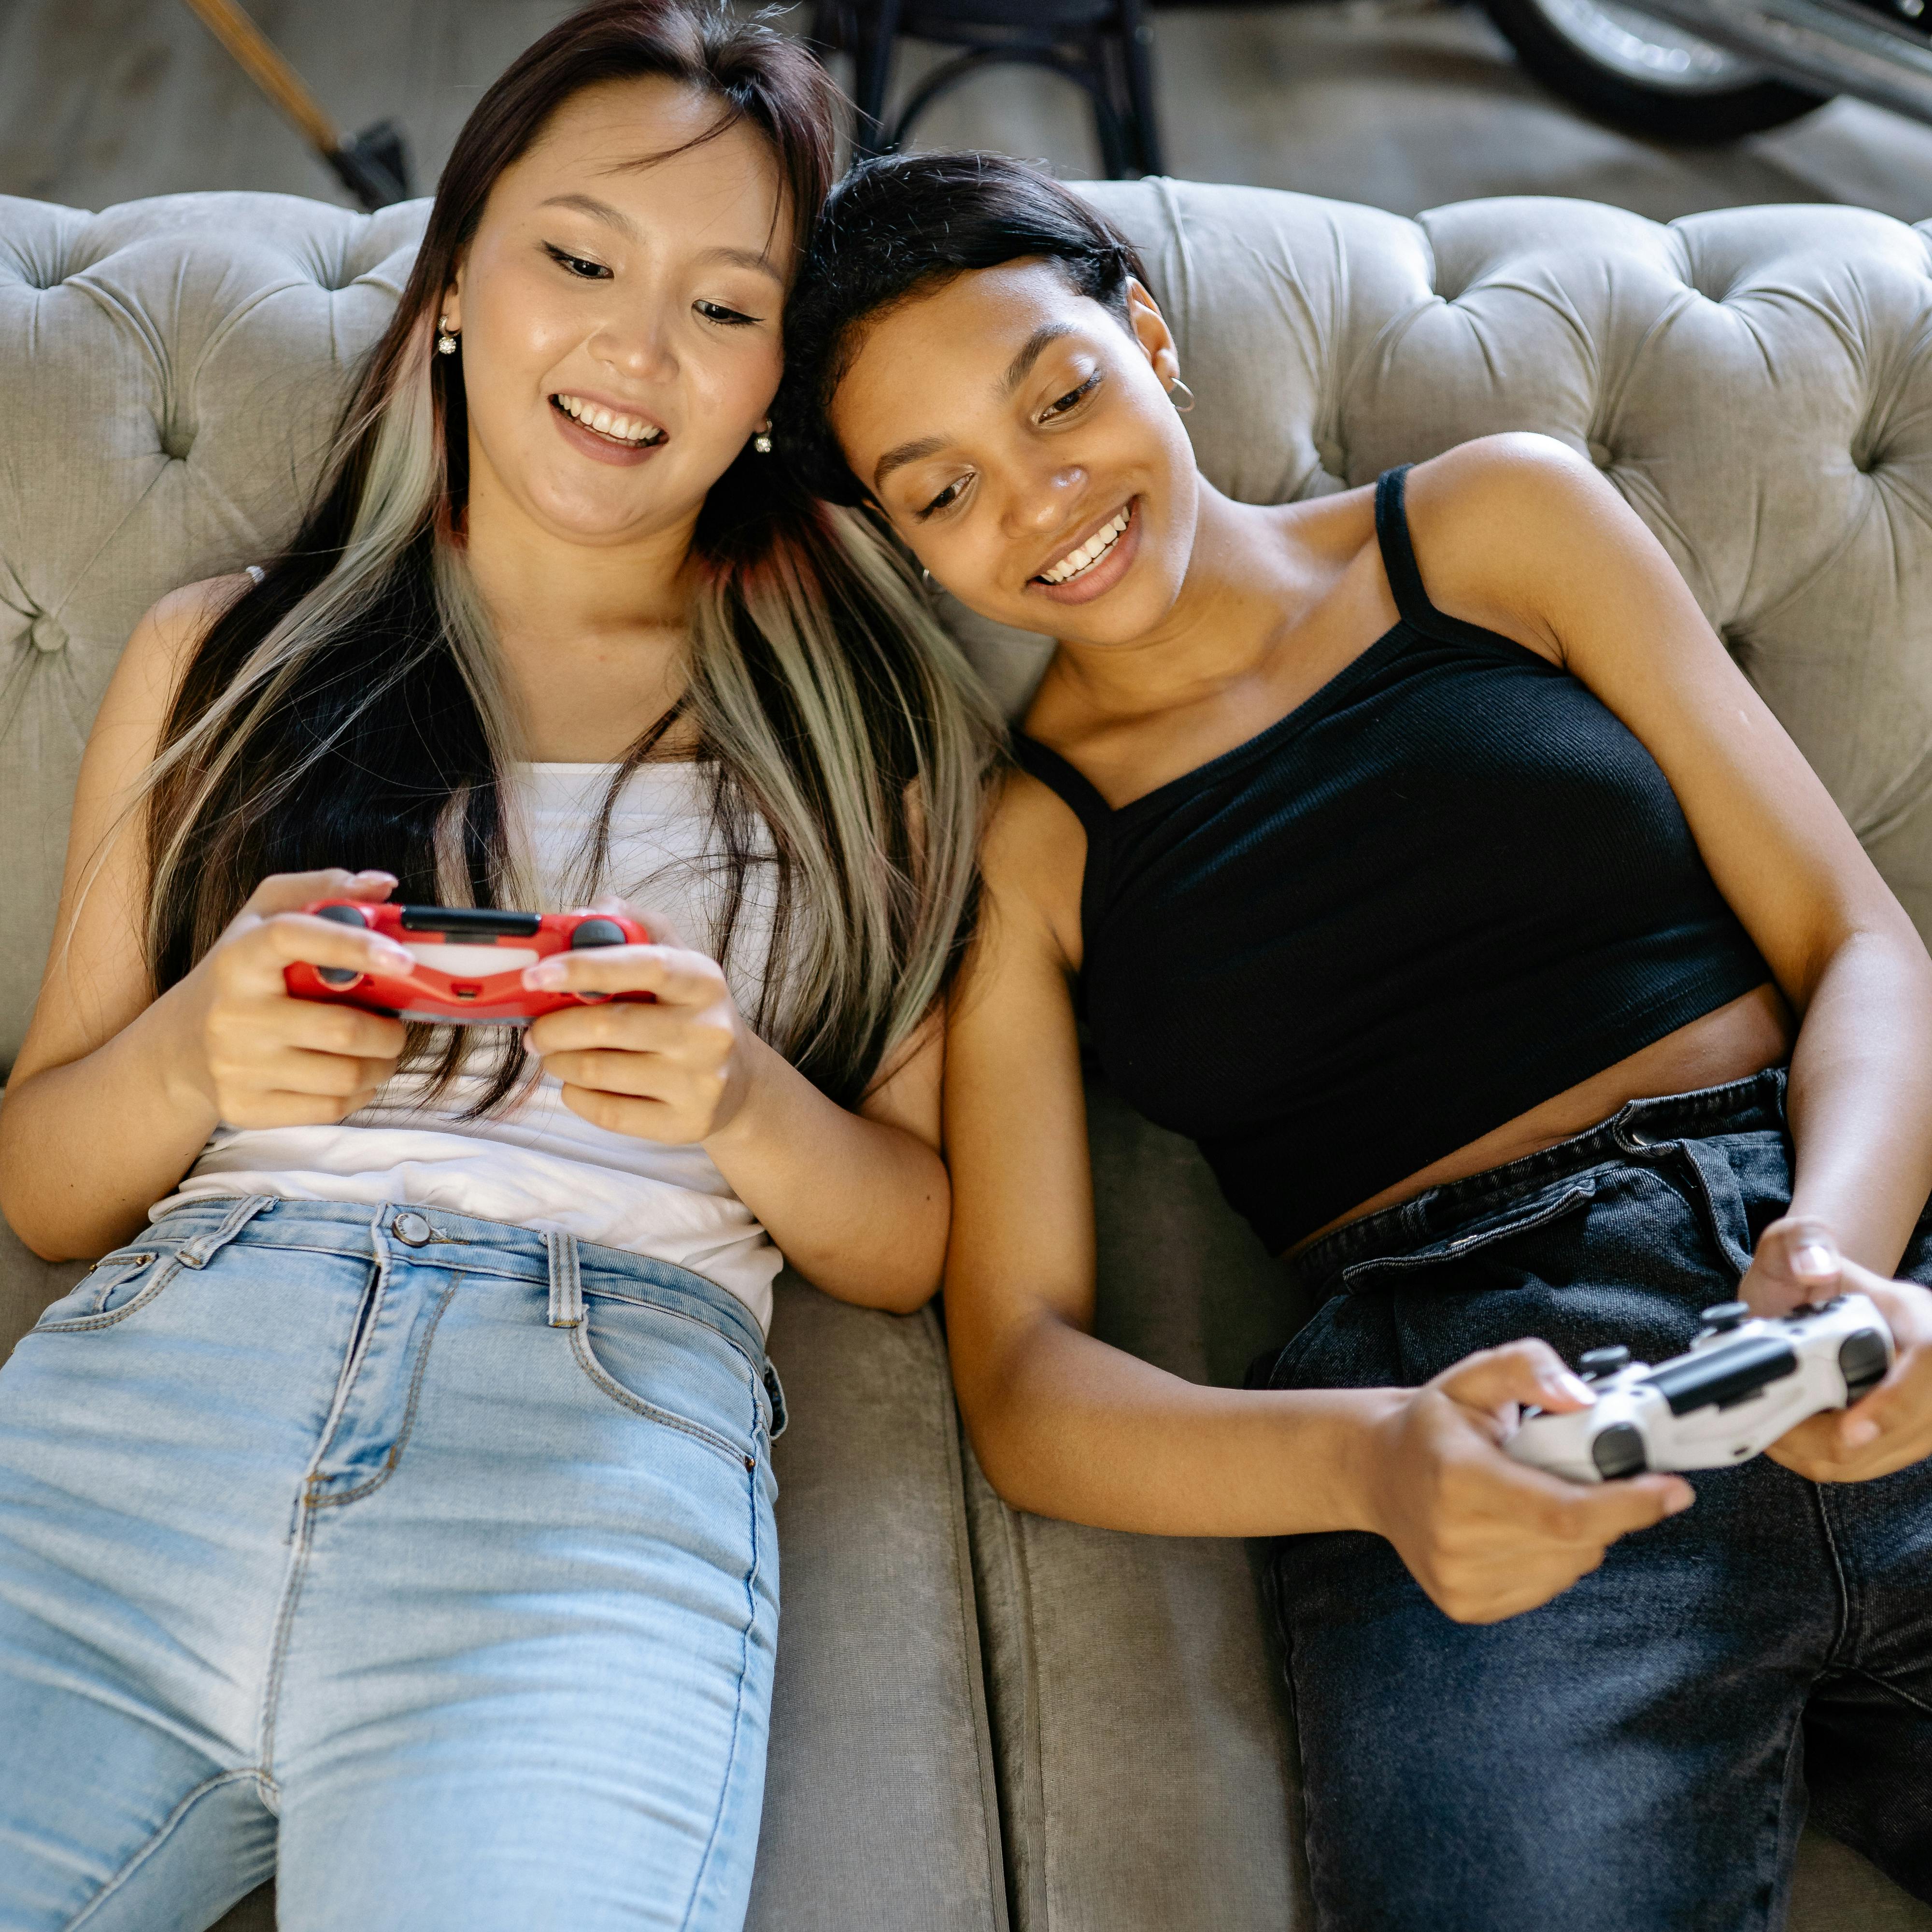
OmniGen peut générer plusieurs images à partir des personnes et des objets présents dans l'image d'entrée et prend en charge la saisie simultanée de plusieurs images. De plus, OmniGen peut extraire les objets souhaités d'une image contenant plusieurs objets sur la base d'instructions.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

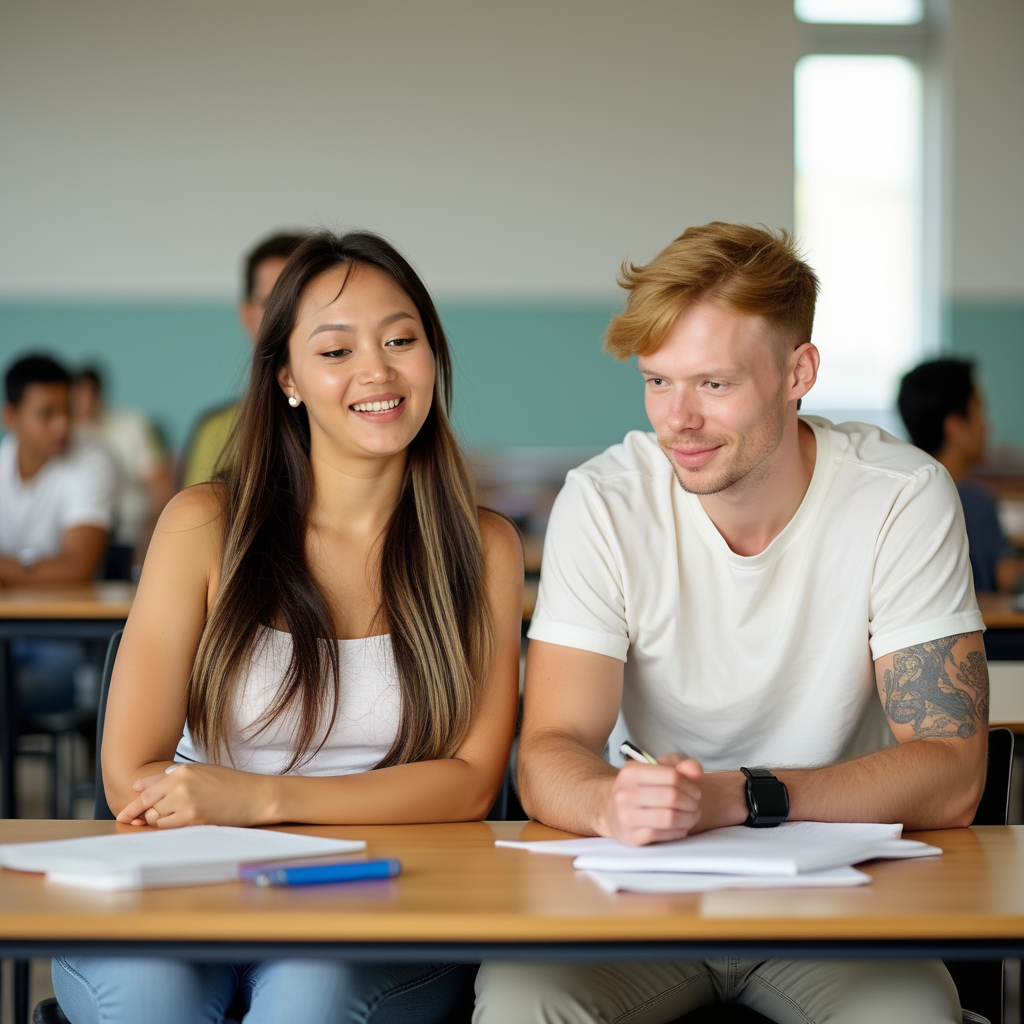
prompt="A man and a woman are sitting at a classroom desk. The man is the man with yellow hair in <img><|image_1|></img>. The woman is the woman on the left of <img><|image_2|></img>"
input_image_1 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/3.png")
input_image_2 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/4.png")
input_images=[input_image_1, input_image_2]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    height=1024,
    width=1024,
    guidance_scale=2.5,
    img_guidance_scale=1.6,
    generator=torch.Generator(device="cpu").manual_seed(666)
).images[0]
image.save("output.png")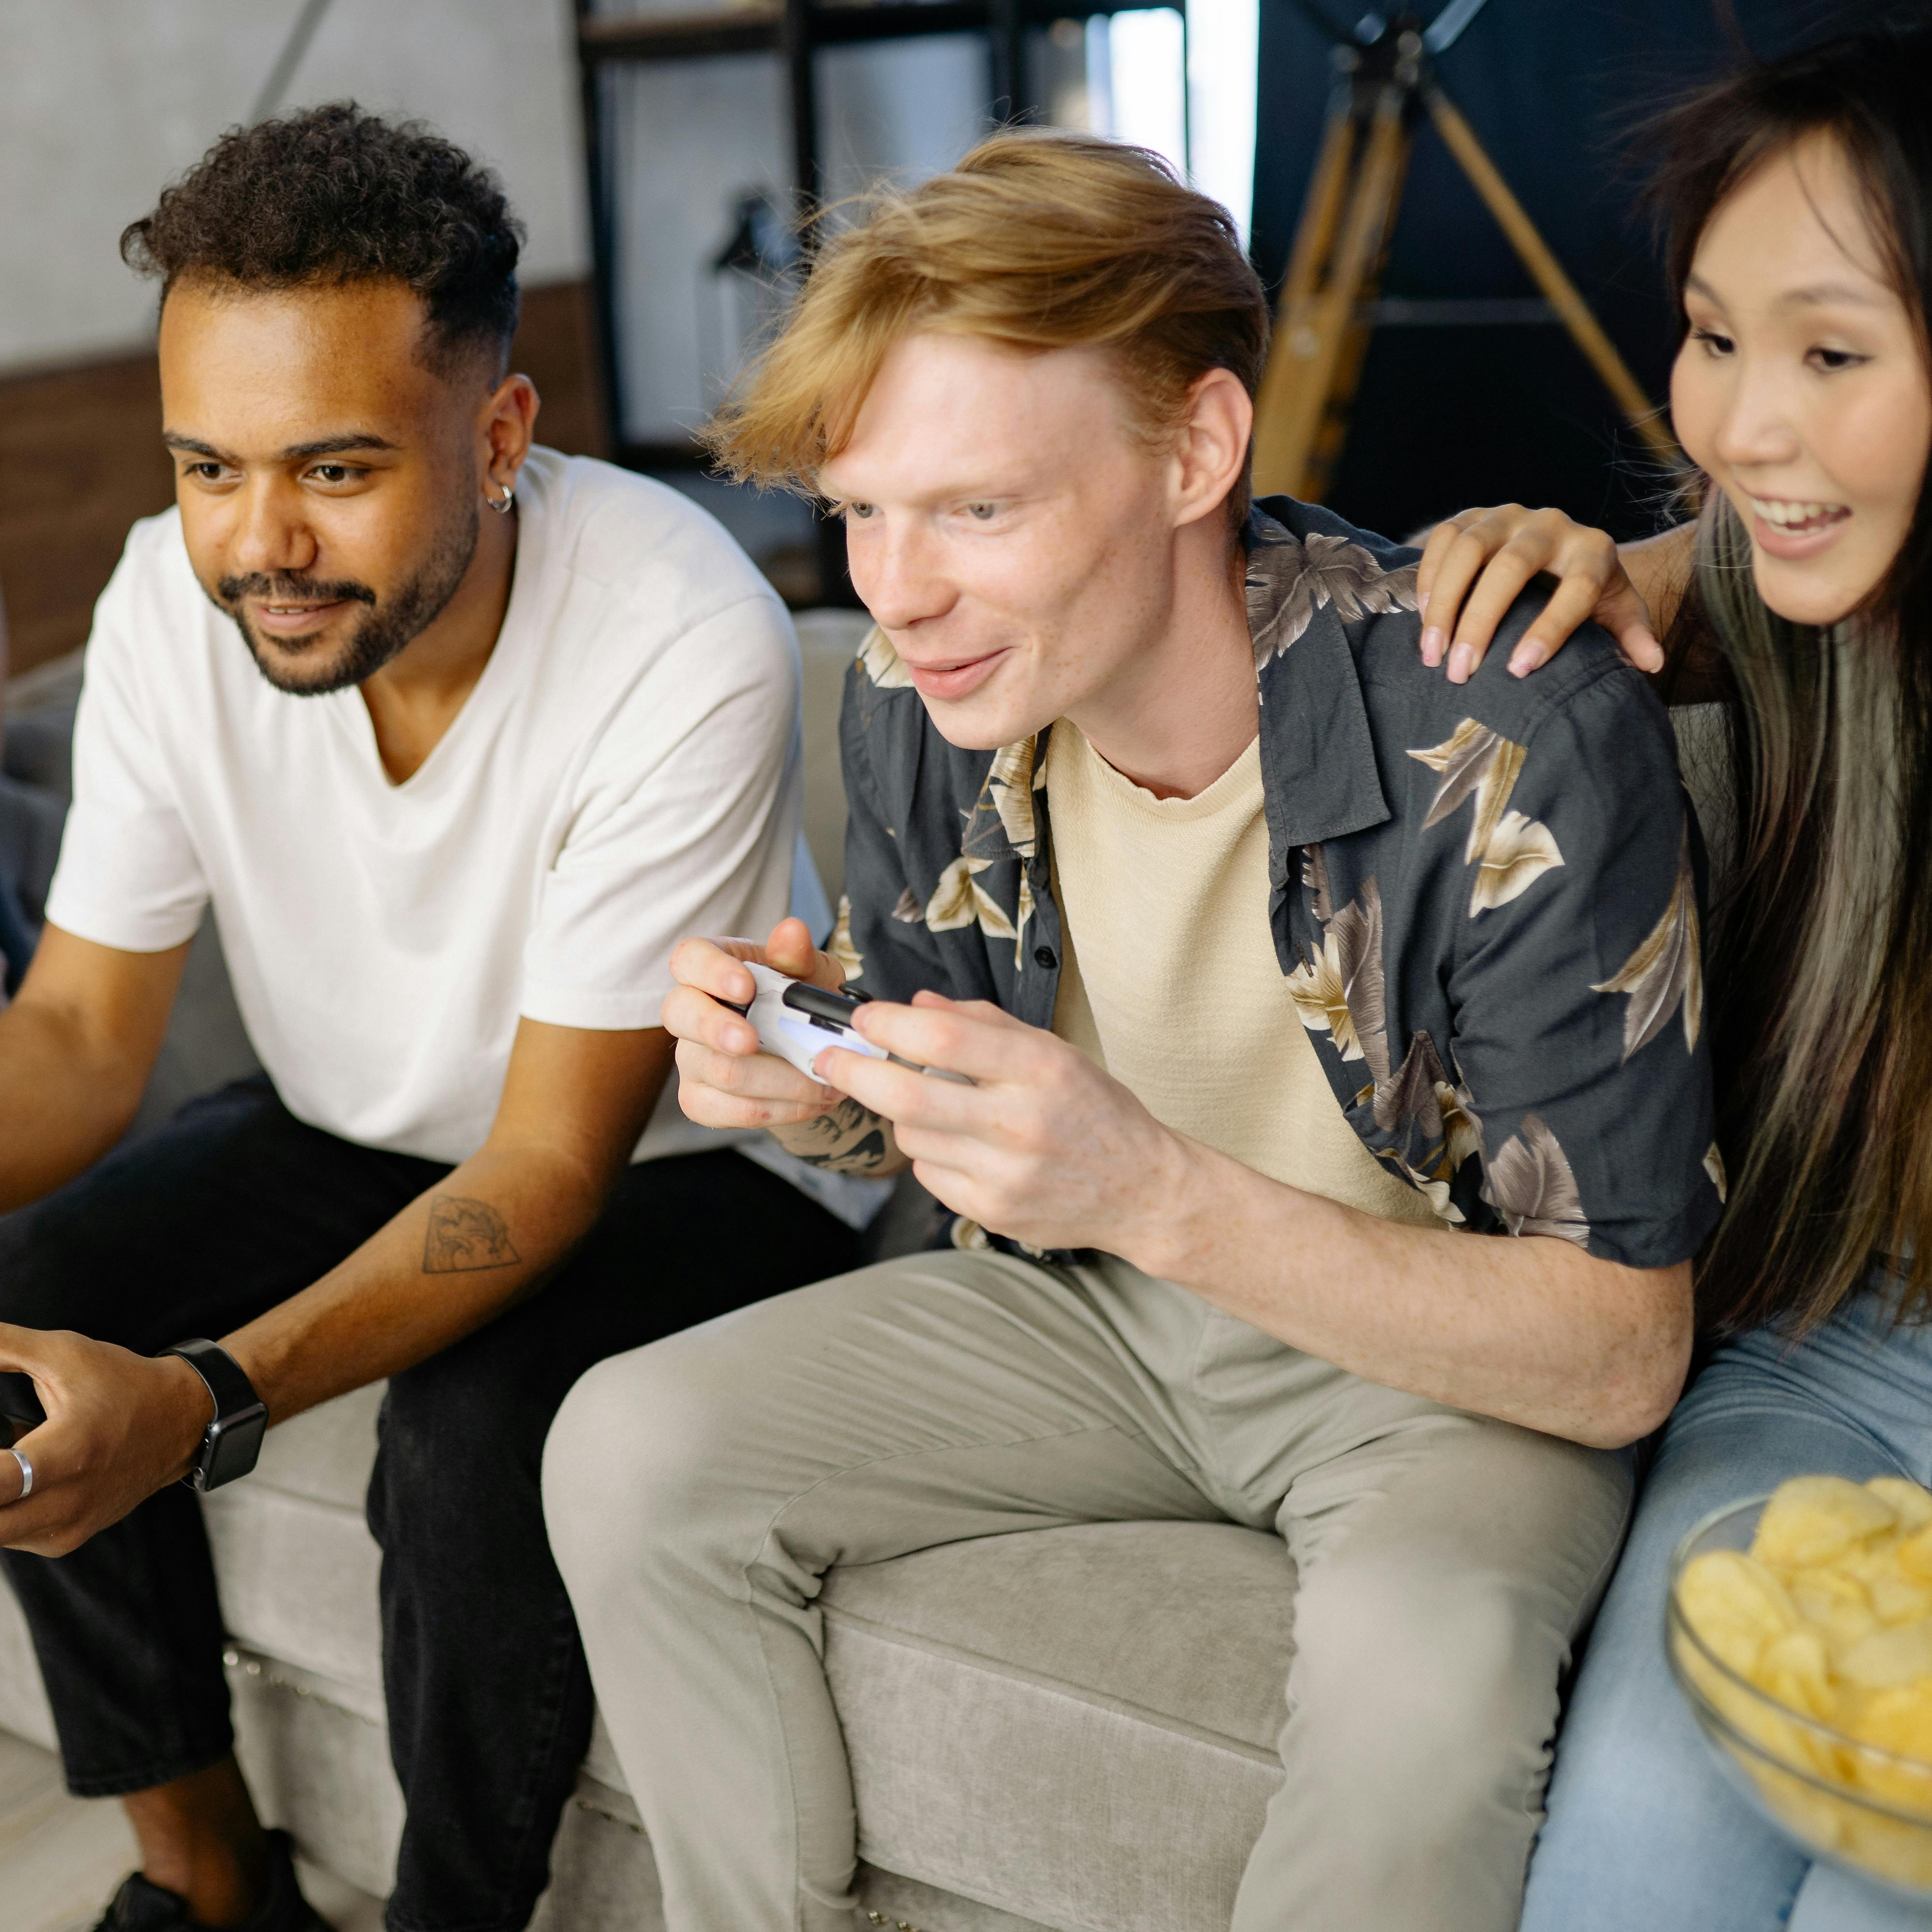
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

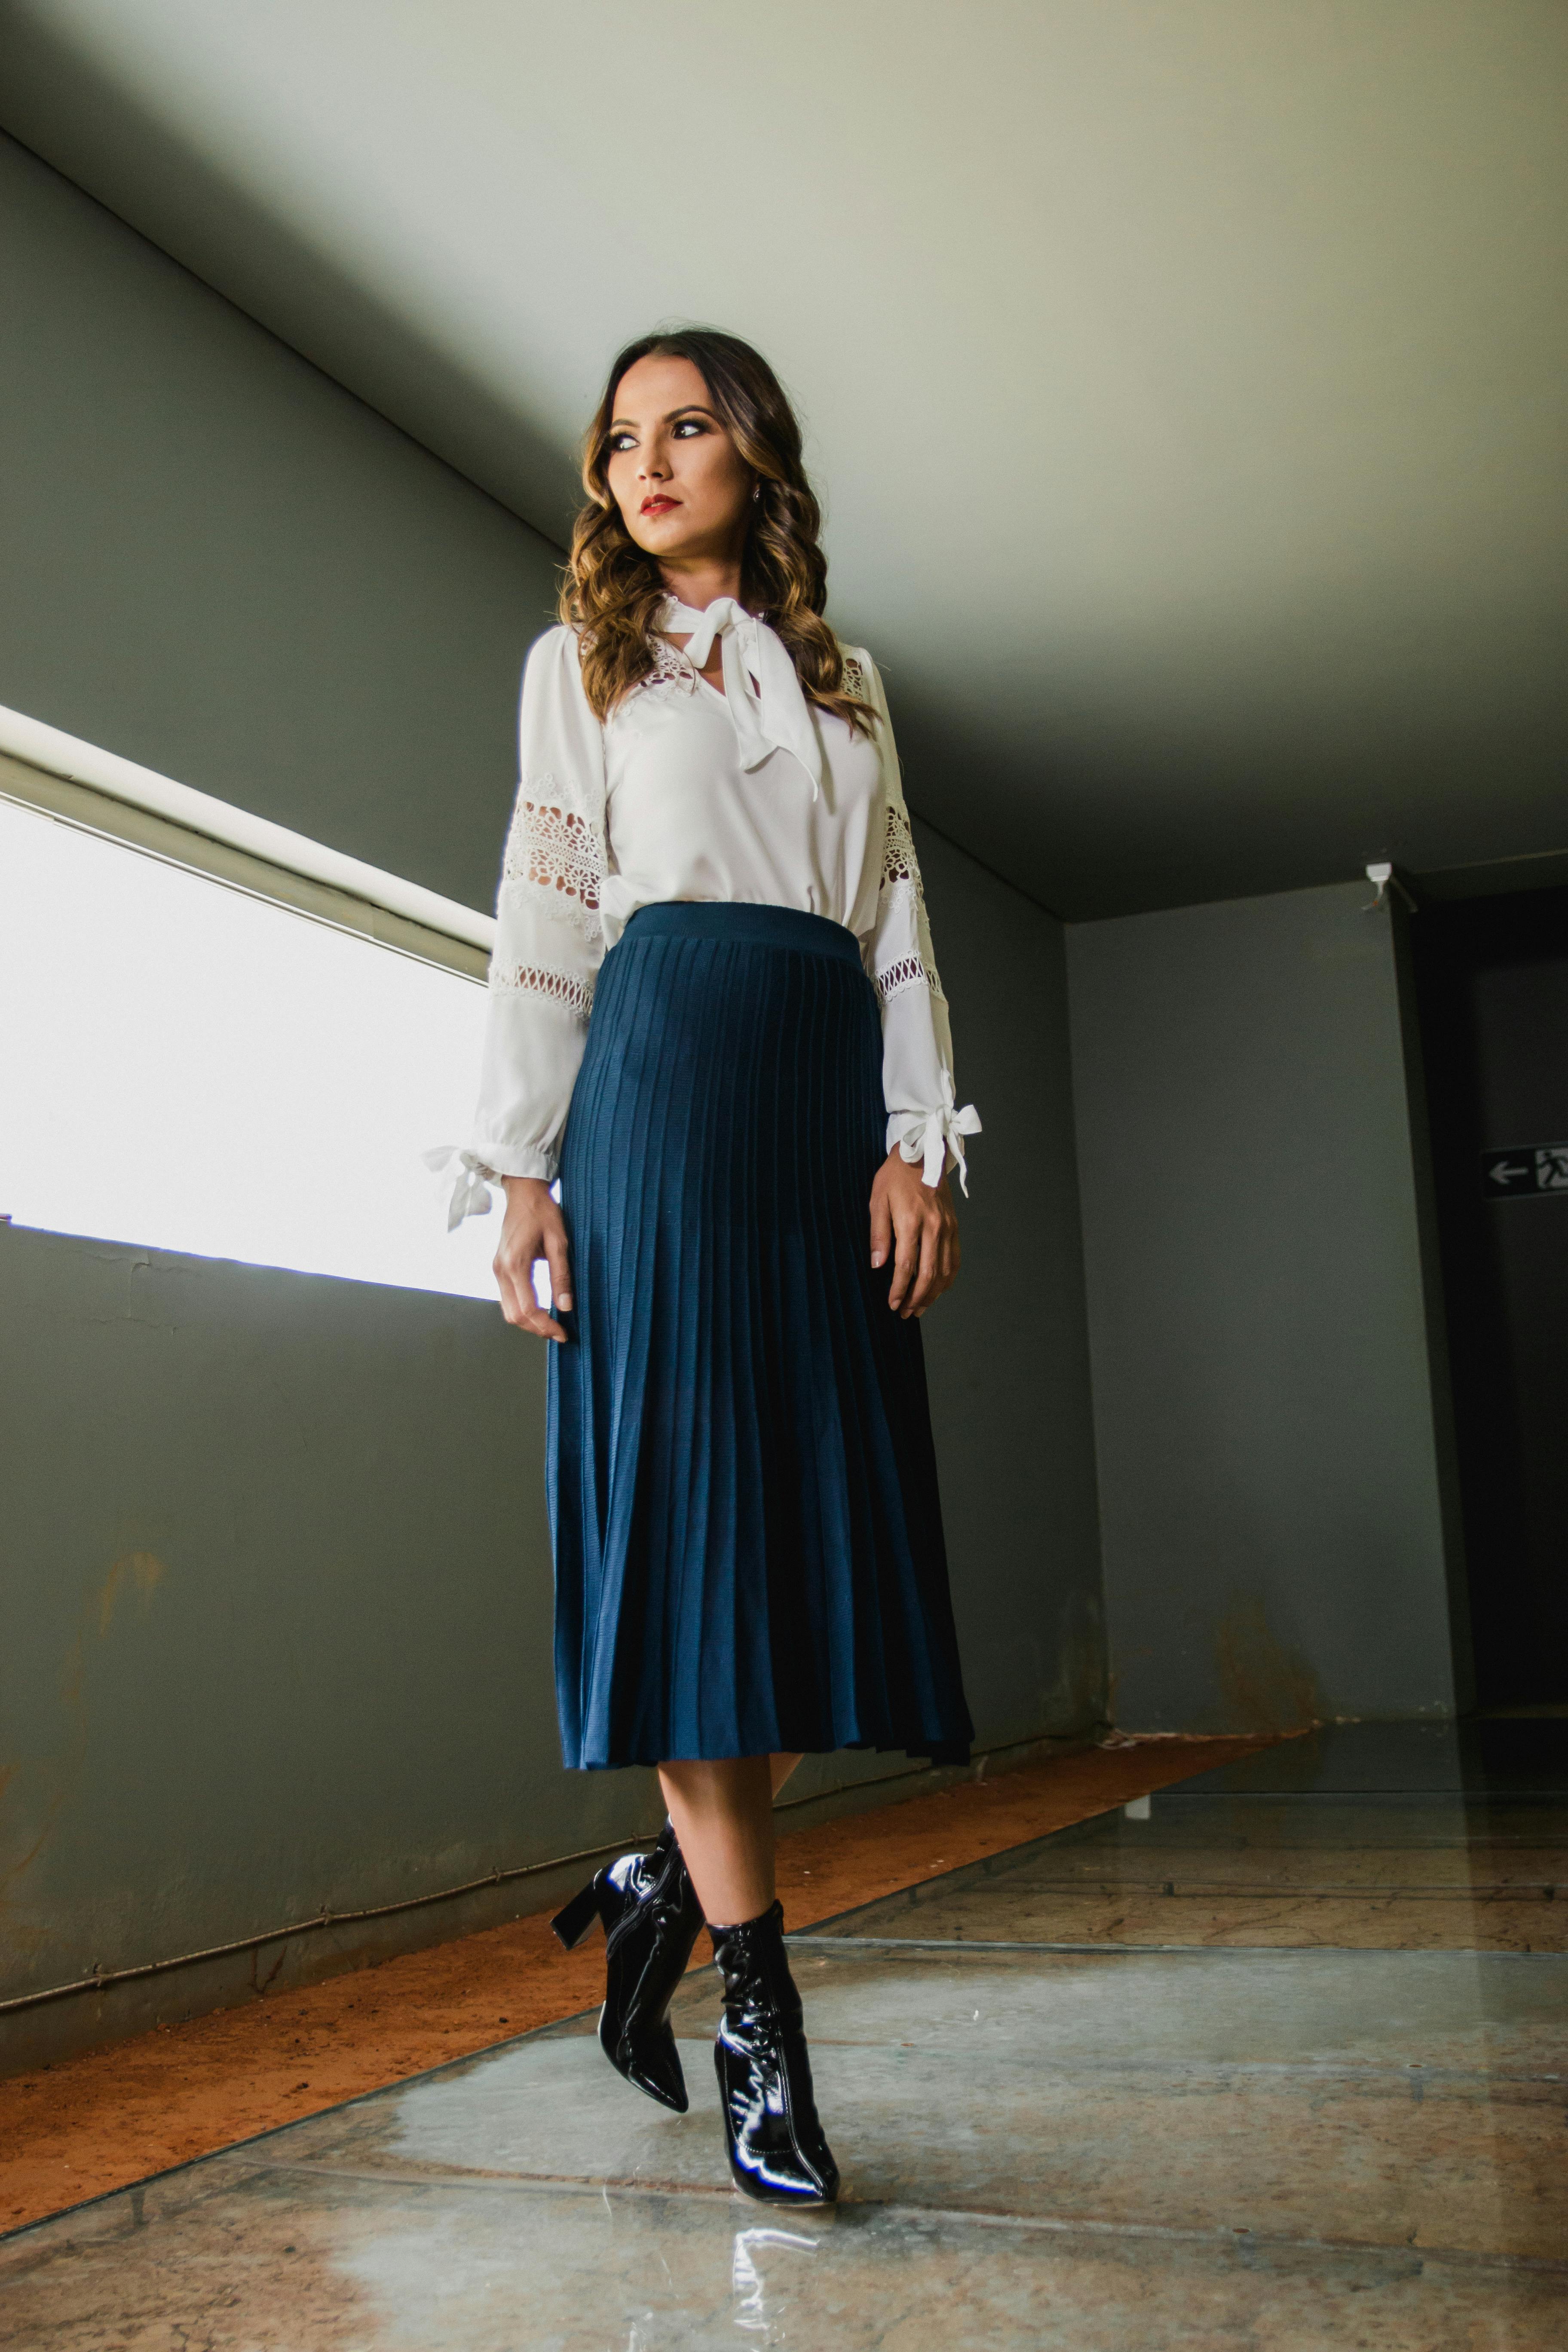
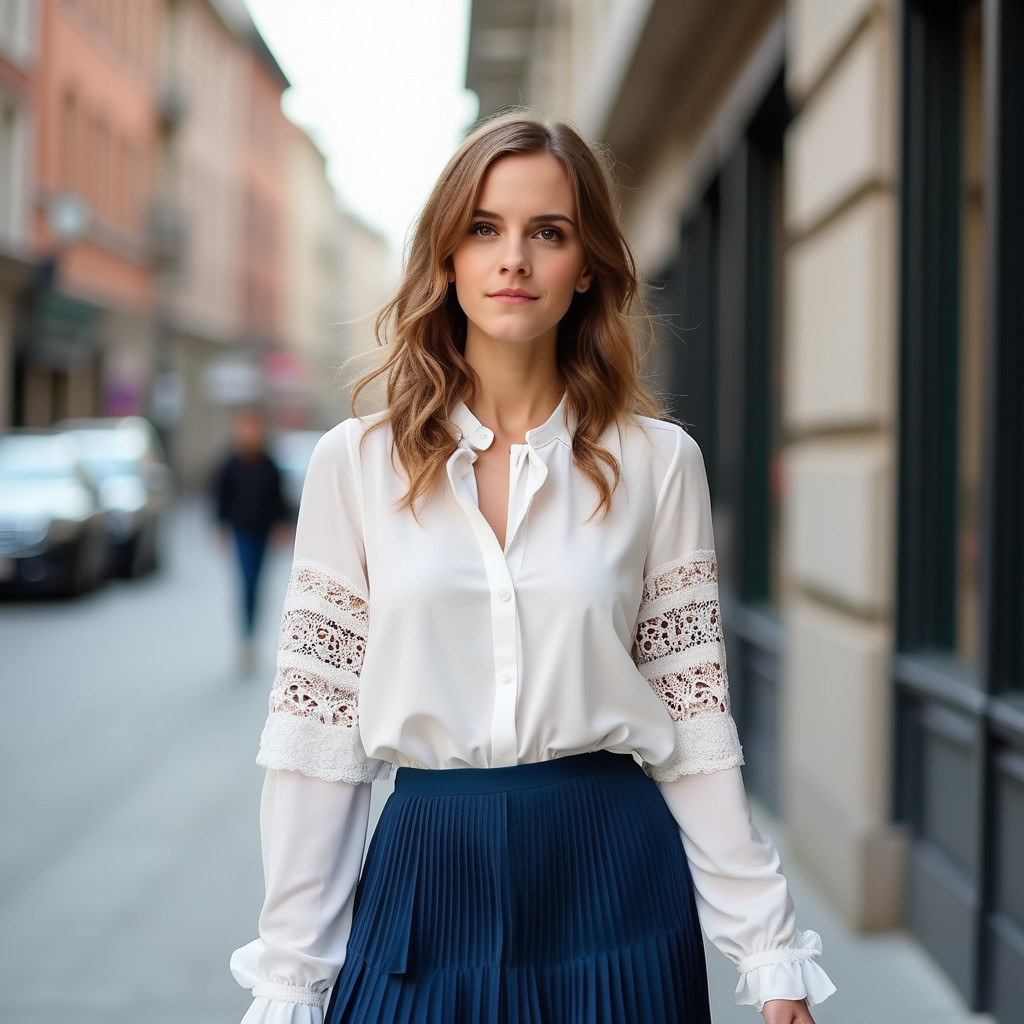
prompt="A woman is walking down the street, wearing a white long-sleeve blouse with lace details on the sleeves, paired with a blue pleated skirt. The woman is <img><|image_1|></img>. The long-sleeve blouse and a pleated skirt are <img><|image_2|></img>."
input_image_1 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/emma.jpeg")
input_image_2 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/dress.jpg")
input_images=[input_image_1, input_image_2]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    height=1024,
    width=1024,
    guidance_scale=2.5,
    img_guidance_scale=1.6,
    generator=torch.Generator(device="cpu").manual_seed(666)
).images[0]
image.save("output.png")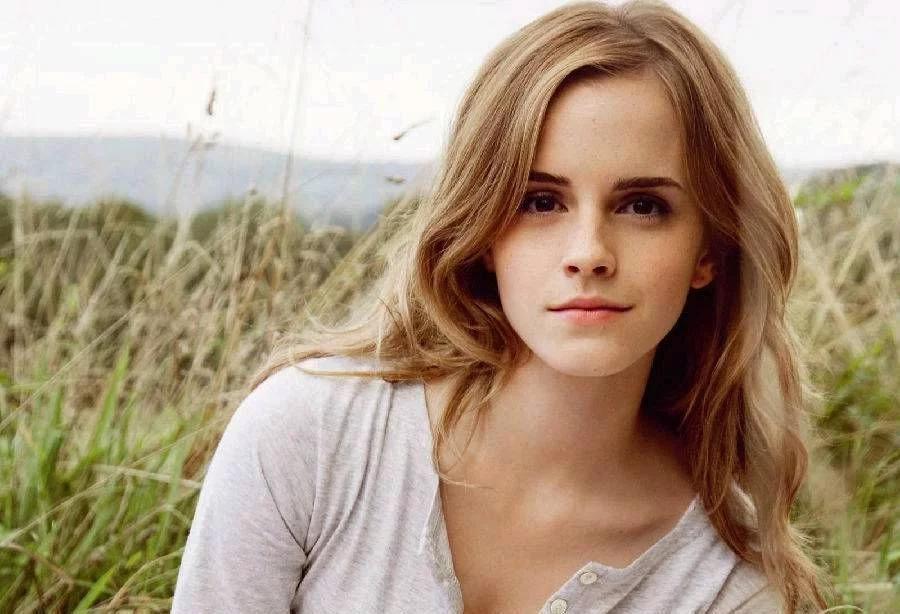
Optimisation lors de l'utilisation de plusieurs images
Pour la tâche de génération d’images à partir de texte, OmniGen nécessite un coût mémoire et temporel minimal (9 Go de mémoire et 31 s pour une image de 1024x1024 sur un GPU A800). Cependant, lors de l’utilisation d’images en entrée, le coût de calcul augmente.
Voici quelques directives pour vous aider à réduire les coûts de calcul lors de l'utilisation de plusieurs images. Les expériences sont réalisées sur un GPU A800 avec deux images en entrée.
Comme pour les autres pipelines, vous pouvez réduire l’utilisation de la mémoire en déplaçant le modèle : pipe.enable_model_cpu_offload() ou pipe.enable_sequential_cpu_offload().
Dans OmniGen, vous pouvez également diminuer la surcharge de calcul en réduisant max_input_image_size.
La consommation de mémoire pour différentes tailles d’image est présentée dans le tableau ci-dessous :
| Méthode | Utilisation de la mémoire |
|---|---|
| max_input_image_size=1024 | 40 Go |
| max_input_image_size=512 | 17 Go |
| max_input_image_size=256 | 14 Go |
OmniGenPipeline
classe diffusers.OmniGenPipeline
< source >( transformer: OmniGenTransformer2DModelscheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtokenizer: LlamaTokenizer )
Paramètres
- transformer (OmniGenTransformer2DModel) — Architecture de Transformer autorégressive pour OmniGen.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Un planificateur à utiliser en combinaison avec
transformerpour débruyer les latents d'image encodés. - vae (AutoencoderKL) — Modèle de Variational Auto-Encoder (VAE) pour encoder et décoder des images vers et depuis des représentations latentes.
- tokenizer (
LlamaTokenizer) — Tokeniseur de texte de la classe LlamaTokenizer.
Le pipeline OmniGen pour la génération d'images à partir de multimodal.
Référence : https://huggingface.co/papers/2409.11340
__call__
< source >( prompt: str | list[str]input_images: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = Noneheight: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 50max_input_image_size: int = 1024timesteps: list = Noneguidance_scale: float = 2.5img_guidance_scale: float = 1.6use_input_image_size_as_output: bool = Falsenum_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents'] ) → ImagePipelineOutput or tuple
Paramètres
- prompt (
stroulist[str], facultatif) — Le prompt ou les prompts pour guider la génération d’images. Si l’entrée contient des images, il faut ajouter les espaces réservés<img><|image_i|></img>dans le prompt pour indiquer la position de la i-ème image. - input_images (
PipelineImageInputoulist[PipelineImageInput], facultatif) — La liste des images d’entrée. Nous remplacerons « <|image_i|> » dans le prompt par la i-ème image de la liste. - height (
int, facultatif, par défaut self.unet.config.sample_size * self.vae_scale_factor) — La hauteur en pixels de l'image générée. Cette valeur est fixée à 1024 par défaut pour obtenir les meilleurs résultats. - width (
int, facultatif, par défaut self.unet.config.sample_size * self.vae_scale_factor) — La largeur en pixels de l'image générée. Cette valeur est fixée à 1024 par défaut pour obtenir les meilleurs résultats. - num_inference_steps (
int, facultatif, valeur par défaut 50) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - max_input_image_size (
int, facultatif, valeur par défaut 1024) — la taille maximale de l'image d'entrée, utilisée pour recadrer l'image d'entrée à cette taille maximale - timesteps (
list[int], facultatif) — Timesteps personnalisés à utiliser pour le processus de débruitage avec les planificateurs qui prennent en charge un argumenttimestepsdans leur méthodeset_timesteps. S'il n'est pas défini, le comportement par défaut lorsquenum_inference_stepsest passé sera utilisé. Doit être dans l'ordre décroissant. - guidance_scale (
float, facultatif, valeur par défaut 2,5) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l'équation 2. de Imagen Paper. L'échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d'images étroitement liées auprompttexte, généralement au détriment de la qualité de l'image. - img_guidance_scale (
float, facultatif, valeur par défaut 1.6) — Défini comme l'équation 3 dans Instrucpix2pix. - use_input_image_size_as_output (bool, par défaut False) — indique s'il faut utiliser la taille de l'image d'entrée comme taille de l'image de sortie, ce qui peut être utilisé pour une entrée d'image unique, par exemple pour une tâche d'édition d'image
- num_images_per_prompt (
int, facultatif, valeur par défaut 1) — Le nombre d'images à générer par invite. - generator (
torch.Generatoroulist[torch.Generator], facultatif) — Un ou une liste de générateurs torch pour rendre la génération déterministe. - latents (
torch.Tensor, facultatif) — Latents bruités pré-générés, échantillonnés à partir d’une distribution gaussienne, à utiliser comme entrées pour la génération d’images. Peut être utilisé pour ajuster la même génération avec des prompts différents. S’il n’est pas fourni, un tenseur de latents sera généré par échantillonnage à l’aide dugeneratoraléatoire fourni. - output_type (
str, facultatif, par défaut"pil") — Le format de sortie de l'image générée. Choisissez entre PIL :PIL.Image.Imageounp.array. - return_dict (
bool, facultatif, par défautTrue) — Indique s'il faut retourner un~pipelines.flux.FluxPipelineOutputplutôt qu'un simple tuple. - callback_on_step_end (
Callable, facultatif) — Une fonction appelée à la fin de chaque étape de débruitage pendant l'inférence. La fonction est appelée avec les arguments suivants :callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargscontiendra une liste de tous les tenseurs spécifiés parcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, facultatif) — La liste des entrées tensorielles pour la fonctioncallback_on_step_end. Les tenseurs spécifiés dans la liste seront passés en tant qu'argumentcallback_kwargs. Vous ne pourrez inclure que les variables listées dans l'attribut._callback_tensor_inputsde votre classe de pipeline.
Retourne
ImagePipelineOutput ou tuple
ImagePipelineOutput si return_dict est True,
sinon un tuple. En cas de retour d'un tuple, le premier élément est une liste contenant les images générées.
Fonction appelée lors de l'appel du pipeline pour la génération.
Exemples :
>>> import torch
>>> from diffusers import OmniGenPipeline

>>> pipe = OmniGenPipeline.from_pretrained("Shitao/OmniGen-v1-diffusers", torch_dtype=torch.bfloat16)
>>> pipe.to("cuda")

>>> prompt = "A cat holding a sign that says hello world"
>>> # Depending on the variant being used, the pipeline call will slightly vary.
>>> # Refer to the pipeline documentation for more details.
>>> image = pipe(prompt, num_inference_steps=50, guidance_scale=2.5).images[0]
>>> image.save("output.png")
Retourne : ImagePipelineOutput ou tuple :
Si return_dict est True, ImagePipelineOutput est retourné, sinon un tuple est retourné
dont le premier élément est une liste contenant les images générées.
encode_input_images
< source >( input_pixel_values: listdevice: typing.Optional[torch.device] = Nonedtype: typing.Optional[torch.dtype] = None )
obtenir l'embedding continu des images d'entrée par le VAE
Retourne : torch.Tensor