
Diffusers documentation
Kandinsky 2.1
Kandinsky 2.1
Kandinsky 2.1 fue creado por Arseniy Shakhmatov, Anton Razzhigaev, Aleksandr Nikolich, Vladimir Arkhipkin, Igor Pavlov, Andrey Kuznetsov y Denis Dimitrov.
La descripción de su página de GitHub es:
Kandinsky 2.1 hereda las mejores prácticas de Dall-E 2 y Latent diffusion, mientras introduce algunas ideas nuevas. Como codificador de texto e imagen, utiliza el modelo CLIP y un prior de difusión de imágenes (mapeo) entre los espacios latentes de las modalidades de CLIP. Este enfoque aumenta el rendimiento visual del modelo y abre nuevos horizontes en la fusión de imágenes y la manipulación de imágenes guiada por texto.
El código original se puede encontrar en ai-forever/Kandinsky-2.
Consulta la organización Kandinsky Community en el Hub para obtener los puntos de control oficiales de modelos para tareas como texto a imagen, imagen a imagen y relleno.
Asegúrate de consultar la guía de Schedulers para aprender a explorar el equilibrio entre la velocidad y la calidad del scheduler, y consulta la sección reutilizar componentes entre pipelines para aprender a cargar eficientemente los mismos componentes en múltiples pipelines.
Asegúrate de tener instaladas las siguientes bibliotecas.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
¡El uso de Kandinsky 2.1 y 2.2 es muy similar! La única diferencia es que Kandinsky 2.2 no acepta
promptcomo entrada al decodificar los latentes. En su lugar, Kandinsky 2.2 solo aceptaimage_embedsdurante la decodificación.
Kandinsky 3 tiene una arquitectura más concisa y no requiere un modelo previo. Esto significa que su uso es idéntico al de otros modelos de difusión como Stable Diffusion XL.
Texto a imagen
Para usar los modelos Kandinsky en cualquier tarea, siempre se comienza configurando el pipeline prior para codificar el prompt y generar los embeddings de la imagen. El pipeline prior también genera negative_image_embeds que corresponden al prompt negativo "". Para obtener mejores resultados, se puede pasar un negative_prompt real al pipeline prior, pero esto aumentará el tamaño de lote efectivo del pipeline prior por un factor de 2.
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt, guidance_scale=1.0).to_tuple()
Ahora, pasa todos los prompts y embeddings al KandinskyPipeline para generar una imagen:
image = pipeline(prompt, image_embeds=image_embeds, negative_prompt=negative_prompt, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
import torch

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, guidance_scale=1.0).to_tuple()
Pase image_embeds y negative_image_embeds a KandinskyV22Pipeline para generar una imagen:
image = pipeline(image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
Kandinsky 3 no requiere un modelo previo, por lo que puedes cargar directamente el Kandinsky3Pipeline y pasar un prompt para generar una imagen:
from diffusers import Kandinsky3Pipeline
import torch

pipeline = Kandinsky3Pipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
image = pipeline(prompt).images[0]
image
🤗 Diffusers también proporciona una API de extremo a extremo con KandinskyCombinedPipeline y KandinskyV22CombinedPipeline, lo que significa que no es necesario cargar por separado el pipeline de prior y el pipeline de texto a imagen. El pipeline combinado carga automáticamente tanto el modelo de prior como el decodificador. Si lo deseas, aún puedes establecer valores diferentes para el pipeline de prior con los parámetros prior_guidance_scale y prior_num_inference_steps.
Use AutoPipelineForText2Image para llamar automáticamente a los pipelines combinados por debajo:
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imagefrom diffusers import AutoPipelineForText2Image
import torch
pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imageImagen a imagen
Para la conversión de imagen a imagen, pase la imagen inicial y el prompt de texto para condicionar la imagen al pipeline. Comience cargando el pipeline anterior:
import torch
from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyImg2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")import torch
from diffusers import KandinskyV22Img2ImgPipeline, KandinskyPriorPipeline
prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")Kandinsky 3 no requiere un modelo previo, por lo que puedes cargar directamente el pipeline de imagen a imagen:
from diffusers import Kandinsky3Img2ImgPipeline
from diffusers.utils import load_image
import torch

pipeline = Kandinsky3Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
Descarga una imagen para usarla como condición:
from diffusers.utils import load_image

# download image
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image = original_image.resize((768, 512))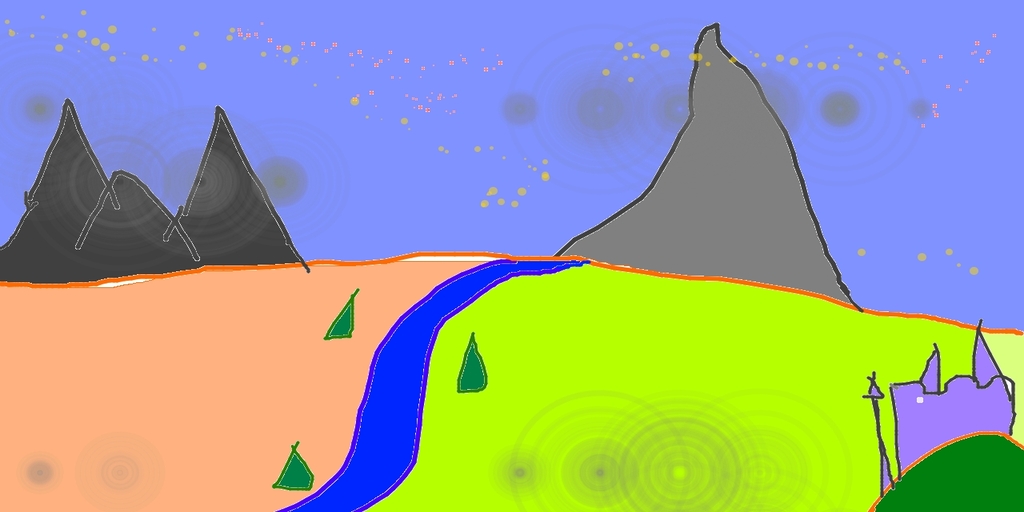
Genere los image_embeds y los negative_image_embeds con el pipeline anterior:
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt).to_tuple()
Ahora, pasa la imagen original, así como todos los prompts y embeddings, a la pipeline para generar una imagen:
from diffusers.utils import make_image_grid

image = pipeline(prompt, negative_prompt=negative_prompt, image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
from diffusers.utils import make_image_grid

image = pipeline(image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
image = pipeline(prompt, negative_prompt=negative_prompt, image=image, strength=0.75, num_inference_steps=25).images[0]
image
🤗 Diffusers también proporciona una API de extremo a extremo con KandinskyImg2ImgCombinedPipeline y KandinskyV22Img2ImgCombinedPipeline, lo que significa que no es necesario cargar por separado el prior y el pipeline de imagen a imagen. El pipeline combinado carga automáticamente tanto el modelo prior como el decodificador. Si lo deseas, aún puedes establecer valores diferentes para el pipeline prior con los parámetros prior_guidance_scale y prior_num_inference_steps.
Use AutoPipelineForImage2Image para llamar automáticamente a los pipelines combinados por debajo:
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch

pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True)
pipeline.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)

original_image.thumbnail((768, 768))

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch
pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image.thumbnail((768, 768))
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)Inpainting
⚠️ Los modelos Kandinsky ahora usan ⬜️ píxeles blancos para representar el área enmascarada en lugar de píxeles negros. Si estás usando KandinskyInpaintPipeline en producción, debes cambiar la máscara para que use píxeles blancos:
# For PIL input
import PIL.ImageOps
mask = PIL.ImageOps.invert(mask)

# For PyTorch and NumPy input
mask = 1 - mask
Para el inpainting, necesitarás la imagen original, una máscara del área a reemplazar en la imagen original y un prompt de texto de lo que se debe inpaintear. Carga el pipeline anterior:
from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyInpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")from diffusers import KandinskyV22InpaintPipeline, KandinskyV22PriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22InpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")Cargue una imagen inicial y cree una máscara:
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
Genere los embeddings con el pipeline anterior:
prompt = "a hat"
prior_output = prior_pipeline(prompt)
Ahora, pasa la imagen inicial, la máscara, el prompt y los embeddings a la pipeline para generar una imagen:
output_image = pipeline(prompt, image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
output_image = pipeline(image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
También puedes usar los pipelines KandinskyInpaintCombinedPipeline y KandinskyV22InpaintCombinedPipeline de extremo a extremo para invocar los pipelines de prior y decodificador juntos por debajo. Usa AutoPipelineForInpainting para esto:
import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid

pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()

init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"

output_image = pipe(prompt=prompt, image=init_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid
pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"
output_image = pipe(prompt=prompt, image=original_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)Interpolación
La interpolación le permite explorar el espacio latente entre los embeddings de imagen y texto, lo cual es una forma interesante de ver algunas de las salidas intermedias del modelo previo. Cargue el pipeline previo y dos imágenes que desee interpolar:
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
from diffusers.utils import load_image, make_image_grid
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
from diffusers.utils import load_image, make_image_grid
import torch
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)

Especifique el texto o las imágenes a interpolar y establezca los pesos para cada texto o imagen. Experimente con los pesos para ver cómo afectan a la interpolación.
images_texts = ["a cat", img_1, img_2]
weights = [0.3, 0.3, 0.4]
Llama a la función interpolate para generar los embeddings y, a continuación, pásalos a la pipeline para generar la imagen:
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
ControlNet
⚠️ ControlNet solo se admite para Kandinsky 2.2.
ControlNet permite condicionar modelos de difusión preentrenados de gran tamaño con entradas adicionales, como un mapa de profundidad o la detección de bordes. Por ejemplo, puedes condicionar Kandinsky 2.2 con un mapa de profundidad para que el modelo comprenda y preserve la estructura de la imagen de profundidad.
Carguemos una imagen y extraigamos su mapa de profundidad:
from diffusers.utils import load_image

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))
img
Luego, puede usar el Pipeline de depth-estimation de 🤗 Transformers para procesar la imagen y obtener el mapa de profundidad:
import torch
import numpy as np

from transformers import pipeline

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
Texto a imagen
Cargue el pipeline anterior y el KandinskyV22ControlnetPipeline:
from diffusers import KandinskyV22PriorPipeline, KandinskyV22ControlnetPipeline

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
Genere los embeddings de imagen a partir de un prompt y un prompt negativo:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

image_emb, zero_image_emb = prior_pipeline(
    prompt=prompt, negative_prompt=negative_prior_prompt, generator=generator
).to_tuple()
Finalmente, pase los embeddings de la imagen y la imagen de profundidad a KandinskyV22ControlnetPipeline para generar una imagen:
image = pipeline(image_embeds=image_emb, negative_image_embeds=zero_image_emb, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
image
Imagen a imagen
Para image-to-image con ControlNet, necesitarás usar:
- KandinskyV22PriorEmb2EmbPipeline para generar los embeddings de imagen a partir de un prompt de texto y una imagen
- KandinskyV22ControlnetImg2ImgPipeline para generar una imagen a partir de la imagen inicial y los embeddings de la imagen
Procesa y extrae un mapa de profundidad de una imagen inicial de un gato con el Pipeline depth-estimation de 🤗 Transformers:
import torch
import numpy as np

from diffusers import KandinskyV22PriorEmb2EmbPipeline, KandinskyV22ControlnetImg2ImgPipeline
from diffusers.utils import load_image
from transformers import pipeline

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
Cargue el pipeline anterior y el KandinskyV22ControlnetImg2ImgPipeline:
prior_pipeline = KandinskyV22PriorEmb2EmbPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetImg2ImgPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
Pase un prompt de texto y la imagen inicial a la pipeline prior para generar los embeddings de la imagen:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

img_emb = prior_pipeline(prompt=prompt, image=img, strength=0.85, generator=generator)
negative_emb = prior_pipeline(prompt=negative_prior_prompt, image=img, strength=1, generator=generator)
Ahora puede ejecutar KandinskyV22ControlnetImg2ImgPipeline para generar una imagen a partir de la imagen inicial y los embeddings de imagen:
image = pipeline(image=img, strength=0.5, image_embeds=img_emb.image_embeds, negative_image_embeds=negative_emb.image_embeds, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
make_image_grid([img.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
Optimizaciones
Kandinsky es único porque requiere un pipeline previo para generar las correspondencias y un segundo pipeline para decodificar los latentes en una imagen. Los esfuerzos de optimización deben centrarse en el segundo pipeline, ya que es donde se realiza la mayor parte del cómputo. A continuación se presentan algunos consejos para mejorar Kandinsky durante la inferencia.
- Habilita xFormers si estás usando PyTorch < 2.0:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_xformers_memory_efficient_attention()- Habilite
torch.compilesi está usando PyTorch >= 2.0 para usar automáticamente scaled dot-product attention (SDPA):
  pipe.unet.to(memory_format=torch.channels_last)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
Esto es lo mismo que establecer explícitamente el procesador de atención para usar AttnAddedKVProcessor2_0:
from diffusers.models.attention_processor import AttnAddedKVProcessor2_0

pipe.unet.set_attn_processor(AttnAddedKVProcessor2_0())- Descargue el modelo a la CPU con enable_model_cpu_offload() para evitar errores de memoria insuficiente:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_model_cpu_offload()- Por defecto, el pipeline de texto a imagen utiliza DDIMScheduler, pero puedes reemplazarlo por otro programador, como DDPMScheduler, para ver cómo afecta al equilibrio entre la velocidad de inferencia y la calidad de la imagen:
from diffusers import DDPMScheduler
from diffusers import DiffusionPipeline

scheduler = DDPMScheduler.from_pretrained("kandinsky-community/kandinsky-2-1", subfolder="ddpm_scheduler")
pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", scheduler=scheduler, dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
KandinskyPriorPipeline
clase diffusers.KandinskyPriorPipeline
< source >( prior: PriorTransformerimage_encoder: CLIPVisionModelWithProjectiontext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizerscheduler: UnCLIPSchedulerimage_processor: CLIPImageProcessorPil )
Parámetros
- prior (PriorTransformer) — El prior unCLIP canónico para aproximar el embedding de imagen a partir del embedding de texto.
- image_encoder (
CLIPVisionModelWithProjection) — Codificador de imágenes congelado. - text_encoder (
CLIPTextModelWithProjection) — Codificador de texto congelado. - tokenizer (
CLIPTokenizer) — Tokenizer de la clase CLIPTokenizer. - scheduler (
UnCLIPScheduler) — Un programador para usar en combinación conpriorpara generar el incrustado de imagen.
Pipeline para generar un prior de imagen para Kandinsky
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0output_type: str | None = 'pt'return_dict: bool = True ) → KandinskyPriorPipelineOutput or tuple
Parámetros
- prompt (
strolist[str]) — El prompt o los prompts para guiar la generación de la imagen. - negative_prompt (
strolist[str], opcional) — El prompt o los prompts que no deben guiar la generación de la imagen. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - num_inference_steps (
int, opcional, valor predeterminado 25) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - latents (
torch.Tensor, opcional) — Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se usarán como entradas para la generación de imágenes. Se pueden utilizar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando elgeneratoraleatorio suministrado. - guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía definida en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 del Imagen Paper. La escala de guía se habilita estableciendoguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen. - output_type (
str, opcional, valor predeterminado"pt") — El formato de salida de la imagen generada. Elija entre:"np"(np.array) o"pt"(torch.Tensor). - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un ImagePipelineOutput en lugar de una tupla simple.
Devuelve
KandinskyPriorPipelineOutput o tuple
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
interpolate
< source >( images_and_prompts: list[typing.Union[str, PIL.Image.Image, torch.Tensor]]weights: list[float]num_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Nonenegative_prior_prompt: str | None = Nonenegative_prompt: str = ''guidance_scale: float = 4.0device = None ) → KandinskyPriorPipelineOutput or tuple
Parámetros
- images_and_prompts (
list[str | PIL.Image.Image | torch.Tensor]) — lista de prompts e imágenes para guiar la generación de imágenes. - weights — (
list[float]): lista de pesos para cada condición enimages_and_prompts - num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - num_inference_steps (
int, opcional, valor predeterminado 25) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - latents (
torch.Tensor, opcional) — Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se usarán como entradas para la generación de imágenes. Se pueden utilizar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando elgeneratoraleatorio suministrado. - negative_prior_prompt (
str, opcional) — El prompt que no debe guiar el proceso de difusión previo. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - negative_prompt (
strolist[str], opcional) — El prompt que no debe guiar la generación de la imagen. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía definida en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 del Imagen Paper. La escala de guía se habilita estableciendoguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen.
Devuelve
KandinskyPriorPipelineOutput o tuple
Función invocada al usar el pipeline anterior para la interpolación.
Ejemplos:
>>> from diffusers import KandinskyPriorPipeline, KandinskyPipeline
>>> from diffusers.utils import load_image
>>> import PIL

>>> import torch
>>> from torchvision import transforms

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> img1 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png"
... )

>>> img2 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/starry_night.jpeg"
... )

>>> images_texts = ["a cat", img1, img2]
>>> weights = [0.3, 0.3, 0.4]
>>> image_emb, zero_image_emb = pipe_prior.interpolate(images_texts, weights)

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16)
>>> pipe.to("cuda")

>>> image = pipe(
...     "",
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=150,
... ).images[0]

>>> image.save("starry_cat.png")
KandinskyPipeline
clase diffusers.KandinskyPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModel )
Parámetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de la clase - scheduler (
DDIMScheduler|DDPMScheduler) — Un scheduler para usar en combinación conunetpara generar latentes de imagen. - unet (UNet2DConditionModel) — Arquitectura U-Net condicional para desruidar el embedding de la imagen.
- movq (VQModel) — Decodificador MoVQ para generar la imagen a partir de los latentes.
Pipeline para la generación de imágenes a partir de texto usando Kandinsky
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parámetros
- prompt (
strolist[str]) — El prompt o los prompts para guiar la generación de la imagen. - image_embeds (
torch.Tensorolist[torch.Tensor]) — Las incrustaciones de imagen de clip para el prompt de texto, que se utilizarán para condicionar la generación de la imagen. - negative_image_embeds (
torch.Tensorolist[torch.Tensor]) — Los embeddings de imagen de clip para el prompt de texto negativo, se usarán para condicionar la generación de la imagen. - negative_prompt (
strolist[str], opcional) — El prompt o los prompts que no deben guiar la generación de la imagen. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - height (
int, opcional, valor predeterminado 512) — La altura en píxeles de la imagen generada. - width (
int, opcional, valor predeterminado 512) — El ancho en píxeles de la imagen generada. - num_inference_steps (
int, opcional, valor predeterminado 100) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía definida en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 del Imagen Paper. La escala de guía se habilita estableciendoguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen. - num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - latents (
torch.Tensor, opcional) — Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se usarán como entradas para la generación de imágenes. Se pueden utilizar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando elgeneratoraleatorio suministrado. - output_type (
str, opcional, valor predeterminado"pil") — El formato de salida de la imagen generada. Elija entre:"pil"(PIL.Image.Image),"np"(np.array) o"pt"(torch.Tensor). - callback (
Callable, opcional) — Una función que se llama cadacallback_stepspasos durante la inferencia. La función se llama con los siguientes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, valor predeterminado 1) — La frecuencia con la que se llama a la funcióncallback. Si no se especifica, la callback se llama en cada paso. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un ImagePipelineOutput en lugar de una tupla simple.
Devuelve
ImagePipelineOutput o tuple
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/Kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
KandinskyCombinedPipeline
clase diffusers.KandinskyCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Parámetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de la clase - scheduler (
DDIMScheduler|DDPMScheduler) — Un scheduler para usar en combinación conunetpara generar latentes de imagen. - unet (UNet2DConditionModel) — Arquitectura U-Net condicional para desruidar el embedding de la imagen.
- movq (VQModel) — Decodificador MoVQ para generar la imagen a partir de los latentes.
- prior_prior (PriorTransformer) — El prior unCLIP canónico para aproximar el embedding de imagen a partir del embedding de texto.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Codificador de imágenes congelado. - prior_text_encoder (
CLIPTextModelWithProjection) — Codificador de texto congelado. - prior_tokenizer (
CLIPTokenizer) — Tokenizer de la clase CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Un programador para usar en combinación conpriorpara generar el incrustado de imagen.
Pipeline combinado para la generación de texto a imagen usando Kandinsky
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parámetros
- prompt (
strolist[str]) — El prompt o los prompts para guiar la generación de la imagen. - negative_prompt (
strolist[str], opcional) — El prompt o los prompts que no deben guiar la generación de la imagen. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - num_inference_steps (
int, opcional, valor predeterminado 100) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - height (
int, opcional, valor predeterminado 512) — La altura en píxeles de la imagen generada. - width (
int, opcional, valor predeterminado 512) — El ancho en píxeles de la imagen generada. - prior_guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía tal como se define en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 de Imagen Paper. La escala de guía se habilita al establecerguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas al textoprompt, generalmente a costa de una menor calidad de imagen. - prior_num_inference_steps (
int, opcional, valor predeterminado 100) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía definida en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 del Imagen Paper. La escala de guía se habilita estableciendoguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - latents (
torch.Tensor, opcional) — Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se usarán como entradas para la generación de imágenes. Se pueden utilizar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando elgeneratoraleatorio suministrado. - output_type (
str, opcional, valor predeterminado"pil") — El formato de salida de la imagen generada. Elija entre:"pil"(PIL.Image.Image),"np"(np.array) o"pt"(torch.Tensor). - callback (
Callable, opcional) — Una función que se llama cadacallback_stepspasos durante la inferencia. La función se llama con los siguientes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, valor predeterminado 1) — La frecuencia con la que se llama a la funcióncallback. Si no se especifica, la callback se llama en cada paso. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un ImagePipelineOutput en lugar de una tupla simple.
Devuelve
ImagePipelineOutput o tuple
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
from diffusers import AutoPipelineForText2Image
import torch

pipe = AutoPipelineForText2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A lion in galaxies, spirals, nebulae, stars, smoke, iridescent, intricate detail, octane render, 8k"

image = pipe(prompt=prompt, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Descarga todos los modelos (los state dicts de unet, text_encoder, vae y safety checker) a la CPU usando 🤗
Accelerate, reduciendo significativamente el uso de memoria. Los modelos se mueven a un torch.device('meta') y se cargan en una
GPU solo cuando se llama al método forward de su submódulo específico. El descargado se realiza a nivel de submódulo.
El ahorro de memoria es mayor que al usar enable_model_cpu_offload, pero el rendimiento es menor.
KandinskyImg2ImgPipeline
clase diffusers.KandinskyImg2ImgPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
Parámetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de la clase - scheduler (DDIMScheduler) —
Un programador para usar en combinación con
unetpara generar latentes de imagen. - unet (UNet2DConditionModel) — Arquitectura U-Net condicional para desruidar el embedding de la imagen.
- movq (VQModel) — Codificador y decodificador de imágenes MoVQ
Pipeline para la generación de imagen a imagen usando Kandinsky
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100strength: float = 0.3guidance_scale: float = 7.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parámetros
- prompt (
strolist[str]) — El prompt o los prompts para guiar la generación de la imagen. - image (
torch.Tensor,PIL.Image.Image) —Image, or tensor representing an image batch, that will be used as the starting point for the process. - image_embeds (
torch.Tensorolist[torch.Tensor]) — Las incrustaciones de imagen de clip para el prompt de texto, que se utilizarán para condicionar la generación de la imagen. - negative_image_embeds (
torch.Tensorolist[torch.Tensor]) — Los embeddings de imagen de clip para el prompt de texto negativo, se usarán para condicionar la generación de la imagen. - negative_prompt (
strolist[str], opcional) — El prompt o los prompts que no deben guiar la generación de la imagen. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - height (
int, opcional, valor predeterminado 512) — La altura en píxeles de la imagen generada. - width (
int, opcional, valor predeterminado 512) — El ancho en píxeles de la imagen generada. - num_inference_steps (
int, opcional, valor predeterminado 100) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - strength (
float, opcional, valor predeterminado 0.3) — Conceptualmente, indica en qué medida se debe transformar laimagede referencia. Debe estar entre 0 y 1.imagese utilizará como punto de partida, añadiendo más ruido a medida que aumenta elstrength. El número de pasos de desruido depende de la cantidad de ruido añadido inicialmente. Cuandostrengthes 1, el ruido añadido será máximo y el proceso de desruido se ejecutará durante el número completo de iteraciones especificado ennum_inference_steps. Un valor de 1, por lo tanto, ignora esencialmenteimage. - guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía definida en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 del Imagen Paper. La escala de guía se habilita estableciendoguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen. - num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - output_type (
str, opcional, valor predeterminado"pil") — El formato de salida de la imagen generada. Elija entre:"pil"(PIL.Image.Image),"np"(np.array) o"pt"(torch.Tensor). - callback (
Callable, opcional) — Una función que se llama cadacallback_stepspasos durante la inferencia. La función se llama con los siguientes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, valor predeterminado 1) — La frecuencia con la que se llama a la funcióncallback. Si no se especifica, la callback se llama en cada paso. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un ImagePipelineOutput en lugar de una tupla simple.
Devuelve
ImagePipelineOutput o tuple
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
>>> from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "A red cartoon frog, 4k"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyImg2ImgPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/frog.png"
... )

>>> image = pipe(
...     prompt,
...     image=init_image,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
...     strength=0.2,
... ).images

>>> image[0].save("red_frog.png")
KandinskyImg2ImgCombinedPipeline
clase diffusers.KandinskyImg2ImgCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Parámetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de la clase - scheduler (
DDIMScheduler|DDPMScheduler) — Un scheduler para usar en combinación conunetpara generar latentes de imagen. - unet (UNet2DConditionModel) — Arquitectura U-Net condicional para desruidar el embedding de la imagen.
- movq (VQModel) — Decodificador MoVQ para generar la imagen a partir de los latentes.
- prior_prior (PriorTransformer) — El prior unCLIP canónico para aproximar el embedding de imagen a partir del embedding de texto.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Codificador de imágenes congelado. - prior_text_encoder (
CLIPTextModelWithProjection) — Codificador de texto congelado. - prior_tokenizer (
CLIPTokenizer) — Tokenizer de la clase CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Un programador para usar en combinación conpriorpara generar el incrustado de imagen.
Pipeline combinado para la generación de imagen a imagen usando Kandinsky
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1strength: float = 0.3height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parámetros
- prompt (
strolist[str]) — El prompt o los prompts para guiar la generación de la imagen. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]olist[np.ndarray]) —Imageo tensor que representa un lote de imágenes, que se utilizará como punto de partida para el proceso. También puede aceptar latentes de imagen comoimage; si se pasan latentes directamente, no se volverá a codificar. - negative_prompt (
strolist[str], opcional) — El prompt o los prompts que no deben guiar la generación de la imagen. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - num_inference_steps (
int, opcional, valor predeterminado 100) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - height (
int, opcional, valor predeterminado 512) — La altura en píxeles de la imagen generada. - width (
int, opcional, valor predeterminado 512) — El ancho en píxeles de la imagen generada. - strength (
float, opcional, valor predeterminado 0.3) — Conceptualmente, indica en qué medida se debe transformar laimagede referencia. Debe estar entre 0 y 1.imagese utilizará como punto de partida, añadiendo más ruido a medida que aumenta elstrength. El número de pasos de desruido depende de la cantidad de ruido añadido inicialmente. Cuandostrengthes 1, el ruido añadido será máximo y el proceso de desruido se ejecutará durante el número completo de iteraciones especificado ennum_inference_steps. Un valor de 1, por lo tanto, ignora esencialmenteimage. - prior_guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía tal como se define en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 de Imagen Paper. La escala de guía se habilita al establecerguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas al textoprompt, generalmente a costa de una menor calidad de imagen. - prior_num_inference_steps (
int, opcional, valor predeterminado 100) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía definida en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 del Imagen Paper. La escala de guía se habilita estableciendoguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - latents (
torch.Tensor, opcional) — Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se usarán como entradas para la generación de imágenes. Se pueden utilizar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando elgeneratoraleatorio suministrado. - output_type (
str, opcional, valor predeterminado"pil") — El formato de salida de la imagen generada. Elija entre:"pil"(PIL.Image.Image),"np"(np.array) o"pt"(torch.Tensor). - callback (
Callable, opcional) — Una función que se llama cadacallback_stepspasos durante la inferencia. La función se llama con los siguientes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, valor predeterminado 1) — La frecuencia con la que se llama a la funcióncallback. Si no se especifica, la callback se llama en cada paso. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un ImagePipelineOutput en lugar de una tupla simple.
Devuelve
ImagePipelineOutput o tuple
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
from diffusers import AutoPipelineForImage2Image
import torch
import requests
from io import BytesIO
from PIL import Image
import os

pipe = AutoPipelineForImage2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"

response = requests.get(url)
image = Image.open(BytesIO(response.content)).convert("RGB")
image.thumbnail((768, 768))

image = pipe(prompt=prompt, image=original_image, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Descarga todos los modelos a la CPU usando accelerate, reduciendo significativamente el uso de memoria. Al llamarlo, unet,
text_encoder, vae y safety checker guardan sus state dicts en la CPU y luego se mueven a un torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.
KandinskyInpaintPipeline
clase diffusers.KandinskyInpaintPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
Parámetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de la clase - scheduler (DDIMScheduler) —
Un programador para usar en combinación con
unetpara generar latentes de imagen. - unet (UNet2DConditionModel) — Arquitectura U-Net condicional para desruidar el embedding de la imagen.
- movq (VQModel) — Codificador y decodificador de imágenes MoVQ
Pipeline para el inpainting de imágenes guiado por texto usando Kandinsky2.1
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, PIL.Image.Image]mask_image: typing.Union[PIL.Image.Image, torch.Tensor, numpy.ndarray]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parámetros
- prompt (
strolist[str]) — El prompt o los prompts para guiar la generación de la imagen. - image (
torch.Tensor,PIL.Image.Imageornp.ndarray) —Image, or tensor representing an image batch, that will be used as the starting point for the process. - mask_image (
PIL.Image.Image,torch.Tensorornp.ndarray) —Image, or a tensor representing an image batch, to maskimage. White pixels in the mask will be repainted, while black pixels will be preserved. You can pass a pytorch tensor as mask only if the image you passed is a pytorch tensor, and it should contain one color channel (L) instead of 3, so the expected shape would be either(B, 1, H, W,),(B, H, W),(1, H, W)or(H, W)If image is an PIL image or numpy array, mask should also be a either PIL image or numpy array. If it is a PIL image, it will be converted to a single channel (luminance) before use. If it is a nummpy array, the expected shape is(H, W). - image_embeds (
torch.Tensorolist[torch.Tensor]) — Las incrustaciones de imagen de clip para el prompt de texto, que se utilizarán para condicionar la generación de la imagen. - negative_image_embeds (
torch.Tensorolist[torch.Tensor]) — Los embeddings de imagen de clip para el prompt de texto negativo, se usarán para condicionar la generación de la imagen. - negative_prompt (
strolist[str], opcional) — El prompt o los prompts que no deben guiar la generación de la imagen. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - height (
int, opcional, valor predeterminado 512) — La altura en píxeles de la imagen generada. - width (
int, opcional, valor predeterminado 512) — El ancho en píxeles de la imagen generada. - num_inference_steps (
int, opcional, valor predeterminado 100) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía definida en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 del Imagen Paper. La escala de guía se habilita estableciendoguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen. - num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - latents (
torch.Tensor, opcional) — Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se usarán como entradas para la generación de imágenes. Se pueden utilizar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando elgeneratoraleatorio suministrado. - output_type (
str, opcional, valor predeterminado"pil") — El formato de salida de la imagen generada. Elija entre:"pil"(PIL.Image.Image),"np"(np.array) o"pt"(torch.Tensor). - callback (
Callable, opcional) — Una función que se llama cadacallback_stepspasos durante la inferencia. La función se llama con los siguientes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, valor predeterminado 1) — La frecuencia con la que se llama a la funcióncallback. Si no se especifica, la callback se llama en cada paso. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un ImagePipelineOutput en lugar de una tupla simple.
Devuelve
ImagePipelineOutput o tuple
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
>>> from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch
>>> import numpy as np

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "a hat"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyInpaintPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png"
... )

>>> mask = np.zeros((768, 768), dtype=np.float32)
>>> mask[:250, 250:-250] = 1

>>> out = pipe(
...     prompt,
...     image=init_image,
...     mask_image=mask,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=50,
... )

>>> image = out.images[0]
>>> image.save("cat_with_hat.png")
KandinskyInpaintCombinedPipeline
clase diffusers.KandinskyInpaintCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Parámetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de la clase - scheduler (
DDIMScheduler|DDPMScheduler) — Un scheduler para usar en combinación conunetpara generar latentes de imagen. - unet (UNet2DConditionModel) — Arquitectura U-Net condicional para desruidar el embedding de la imagen.
- movq (VQModel) — Decodificador MoVQ para generar la imagen a partir de los latentes.
- prior_prior (PriorTransformer) — El prior unCLIP canónico para aproximar el embedding de imagen a partir del embedding de texto.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Codificador de imágenes congelado. - prior_text_encoder (
CLIPTextModelWithProjection) — Codificador de texto congelado. - prior_tokenizer (
CLIPTokenizer) — Tokenizer de la clase CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Un programador para usar en combinación conpriorpara generar el incrustado de imagen.
Pipeline combinado para generación usando Kandinsky
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]mask_image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parámetros
- prompt (
strolist[str]) — El prompt o los prompts para guiar la generación de la imagen. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]olist[np.ndarray]) —Imageo tensor que representa un lote de imágenes, que se utilizará como punto de partida para el proceso. También puede aceptar latentes de imagen comoimage; si se pasan latentes directamente, no se volverá a codificar. - mask_image (
np.array) — Tensor que representa un lote de imágenes, para enmascararimage. Los píxeles blancos de la máscara se repintarán, mientras que los píxeles negros se conservarán. Simask_imagees una imagen PIL, se convertirá a un solo canal (luminancia) antes de su uso. Si es un tensor, debe contener un canal de color (L) en lugar de 3, por lo que la forma esperada sería(B, H, W, 1). - negative_prompt (
strolist[str], opcional) — El prompt o los prompts que no deben guiar la generación de la imagen. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - num_inference_steps (
int, opcional, valor predeterminado 100) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - height (
int, opcional, valor predeterminado 512) — La altura en píxeles de la imagen generada. - width (
int, opcional, valor predeterminado 512) — El ancho en píxeles de la imagen generada. - prior_guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía tal como se define en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 de Imagen Paper. La escala de guía se habilita al establecerguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas al textoprompt, generalmente a costa de una menor calidad de imagen. - prior_num_inference_steps (
int, opcional, valor predeterminado 100) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - guidance_scale (
float, opcional, valor predeterminado 4.0) — Escala de guía definida en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 del Imagen Paper. La escala de guía se habilita estableciendoguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - latents (
torch.Tensor, opcional) — Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se usarán como entradas para la generación de imágenes. Se pueden utilizar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando elgeneratoraleatorio suministrado. - output_type (
str, opcional, valor predeterminado"pil") — El formato de salida de la imagen generada. Elija entre:"pil"(PIL.Image.Image),"np"(np.array) o"pt"(torch.Tensor). - callback (
Callable, opcional) — Una función que se llama cadacallback_stepspasos durante la inferencia. La función se llama con los siguientes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, valor predeterminado 1) — La frecuencia con la que se llama a la funcióncallback. Si no se especifica, la callback se llama en cada paso. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un ImagePipelineOutput en lugar de una tupla simple.
Devuelve
ImagePipelineOutput o tuple
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image
import torch
import numpy as np

pipe = AutoPipelineForInpainting.from_pretrained(
    "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

original_image = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png"
)

mask = np.zeros((768, 768), dtype=np.float32)
# Let's mask out an area above the cat's head
mask[:250, 250:-250] = 1

image = pipe(prompt=prompt, image=original_image, mask_image=mask, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Descarga todos los modelos a la CPU usando accelerate, reduciendo significativamente el uso de memoria. Al llamarlo, unet,
text_encoder, vae y safety checker guardan sus state dicts en la CPU y luego se mueven a un torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.